2026年11月15日 星期日

AMD Venice-X 3D V-Cache原理:快取搬到核心底下,台積電SoIC怎麼撐住SRAM微縮牆

AMD Venice-X 3D V-Cache原理:快取搬到核心底下,台積電SoIC怎麼撐住SRAM微縮牆

AMD Venice-X 3D V-Cache 快取從核心上方改到下方,台積電 SoIC 混合鍵合示意圖

重點先講:AMD 這次發表的 EPYC 9006X「Venice-X」,快取容量沒有變大,還是 1152MB;真正的升級是快取的位置。以前 3D V-Cache 蓋在 CPU 核心上面,現在改墊到核心底下,伺服器 X3D 第一次不用為了大快取犧牲時脈。能這樣搬,靠的是台積電 SoIC 混合鍵合;必須這樣搬,是因為 SRAM 在平面上已經快縮不動了。

原始貼文在這:FB:AMD X3D,是台積電 3D DRAM 最好的試金石(SRAM 為什麼貴又難縮,粉專也拆過:台積電,才是 SRAM 之王)

發生了什麼

  • 11 月 10~11 日,AMD 預告 EPYC 9006X「Venice-X」:最多 96 顆 Zen 6 核心、192 執行緒、1152MB L3,鎖定 EDA 模擬、HPC 這類吃快取的工作,2027 下半年上市,微軟已說會用在 Azure HXv2 執行個體。
  • 時脈:Tom's Hardware、Wccftech 報導最高 5.3GHz;VideoCardz 的整理寫約 5.15GHz(粉專原文也用 5.15GHz)。正式規格要等上市前公布,但兩個數字都遠高於上一代 Genoa-X(EPYC 9684X)的 3.7GHz。
  • Wccftech 拆算:8 個 CCD,每個 CCD 本身 48MB L3,再加 96MB 堆疊快取,合計 384MB+768MB=1152MB。
  • 平台:SP7 插槽、16 通道記憶體,支援 MRDIMM-12800,每顆約 1.6TB/s 記憶體頻寬、96 條 PCIe 6.0。Zen 6 CCD 是 AMD 第一個在台積電 N2 投片的 HPC 產品。
  • 伺服器版 X3D 上一次出現是 2023 年的 Genoa-X,Turin 世代整整缺席一代。
一句話比喻:
舊做法=在爐子上蓋一條棉被(快取壓在核心上,熱要穿過快取才散得掉)。
新做法=把儲藏室搬到地下室(快取墊在底下,核心直接貼散熱蓋)。
東西一樣多,但廚房不再悶熱,爐火可以開大。
工程重點 1:為什麼「放上面」會卡時脈

CPU 的熱幾乎都來自核心。第一代、第二代伺服器 X3D(Milan-X、Genoa-X)把 SRAM 晶片疊在核心上方,熱要先穿過那層矽與鍵合介面才到散熱蓋,等於多一層熱阻;SRAM 本身也怕熱。結果就是電壓、時脈都要壓低,Genoa-X 加速只有 3.7GHz,很多客戶寧可買不疊快取的高時脈版。桌機的 Ryzen 9000X3D 先把順序反過來,快取墊在下面、核心在上面,這次 Venice-X 把同一招帶進伺服器,大快取和高時脈終於不用二選一。

工程重點 2:台積電 SoIC 混合鍵合,凸塊直接拿掉

一般 3D 堆疊用微凸塊(micro bump)焊在一起,間距大約幾十微米。SoIC 用的是混合鍵合:兩片晶片表面磨到極平,銅墊對銅墊、氧化層對氧化層直接接合,沒有焊料。AMD 公布的數字是,相比微凸塊 3D,互連密度超過 15 倍、互連能效超過 3 倍;第一代 3D V-Cache 的連接間距約 9 微米。快取改放底下後,核心的電源與訊號必須穿過下面那顆快取晶片的 TSV 才接到封裝,這對 TSV 密度、供電壓降和鍵合良率要求更高,這也是只有 SoIC 這級技術做得到的原因。

工程重點 3:SRAM 微縮撞牆,平面塞不下只能往上

SRAM 一個位元要 6 顆電晶體,速度快但很佔面積。更麻煩的是它越來越難縮:台積電 N3E 的高密度 SRAM 單元約 0.021 平方微米,和 N5 幾乎一樣;N2 靠 GAA 縮到約 0.0175 平方微米(台積電 IEDM 2024 數據),一代才小約兩成,遠不如邏輯電路。所以把大快取做在最貴的 N2 核心晶片上很不划算,把快取拆到另一顆晶片、用較成熟的製程做,再疊上來,成本和良率都比較好算。這就是粉專說「X3D 是試金石」的意思:記憶體貼著運算放,方向已經被證明是對的。

工程重點 4:下一步,疊的會不會從 SRAM 換成 DRAM

Venice-X 的快取總量和兩年多前的 Genoa-X 一樣,說明單靠 SRAM 往上疊,容量成長很慢。要再大一個數量級,就得換密度更高的記憶體:之前寫過的台積電 2T0C拿掉電容、可以長在邏輯上方;Fractile 把 DRAM 疊在運算晶片上也是同一條思路。不管最後疊的是 SRAM、2T0C 還是 DRAM,都需要 SoIC 這類混合鍵合,台積電在每一條路線上都賣得到鏟子。

還缺什麼/待核

  • Venice-X 最高時脈有 5.3GHz 與約 5.15GHz 兩種報導,TDP、SKU 數量、底座時脈都未公布。
  • AMD 沒說 Venice-X 堆疊快取晶片用哪個製程,以及鍵合間距是否比第一代更小。
  • 「快取放底下」帶來的散熱好處,桌機 Ryzen 9000X3D 已有實測;伺服器 96 核心滿載下效果多大,要等 2027 年實測。
  • 台積電是否、以及何時把 2T0C 疊上邏輯晶片商用,官方沒有證實。

延伸影片

黃仁勳說 AI 的盡頭是電!微型核能 vs 燃料電池,誰能拯救算力荒?黃仁勳說 AI 的盡頭是電!微型核能 vs 燃料電池,誰能拯救算力荒?

快取貼著核心放,最大的好處之一是少搬資料、少耗電。資料中心的電力壓力,這支影片講得更完整。

你覺得下一代會繼續疊 SRAM,還是直接換成 2T0C 或 DRAM?留言聊聊。

資料來源:Tom's Hardware(2026-11-11)、Wccftech(2026-11-10)、VideoCardz、ComputerBase 對 AMD EPYC 9006 系列的報導;台積電 IEDM 2024 N2 SRAM 數據;AMD 3D V-Cache 技術資料;FB 粉專原文。
原始貼文在這:https://www.facebook.com/1147074221177116/posts/1160610763156795
本文由 vkinngworld/@vkinng 整理。半導體新聞每天在粉專拆,歡迎來留言:FB 粉專「PLC」

2026年11月14日 星期六

繞開HBM的AI晶片:Fractile把DRAM疊上去、Axelera改用LPDDR6,兩條路架構比較

繞開HBM的AI晶片:Fractile把DRAM疊上去、Axelera改用LPDDR6,兩條路架構比較

繞開HBM的兩條路:Fractile 3D堆疊DRAM與Axelera LPDDR6架構比較圖

重點先講:AI 推論的瓶頸越來越不是算力,而是記憶體搬資料的速度。現在的標準答案是 HBM+台積電 CoWoS,但 HBM 又貴又缺、CoWoS 產能被大廠包光。這週兩家新創給了兩個不同答案:Fractile 把 DRAM 往上疊,Axelera 把 HBM 換成 LPDDR6。這篇把兩條路拆開,用數字看各自賭的是什麼。

原始貼文在這:FB:Fractile 募了 7.2 億美元,就是要繞開 HBM!(Axelera 那篇也在粉專:拒絕 HBM 綁架與水冷天價)

發生了什麼

  • 11 月 11 日,英國 Fractile 完成 7.2 億美元 C 輪,投後估值約 70 億美元,由 Thrive、Founders Fund、Lightspeed、Redpoint 共同領投,Alphabet 旗下 CapitalG 與英國主權 AI 基金參與。累計募資約 9.55 億美元。
  • Fractile 的做法:不用 HBM,把標準 DRAM 直接封裝在邏輯晶片正上方,宣稱頻寬遠高於 HBM、容量遠大於 SRAM。首批晶片與系統預計 2027 年出貨。
  • Bloomberg 8 月報導 Anthropic 初步同意採購約 2.5 億美元 Fractile 晶片(雙方未證實)。
  • 11 月 12 日,荷蘭 Axelera AI 公布第三代架構 Titania:雙小晶片封裝、2.5 PFLOPS(FP8)、400 W、128 GB LPDDR6、2,458 GB/s。2027 年 Q3 量產,已有超過 3 億美元客戶部署承諾。
一句話分清楚:
HBM+CoWoS=記憶體放在晶片「旁邊」,靠中介層上上千條線並排傳。
Fractile=記憶體疊在晶片「上面」,垂直連接,距離最短。
Axelera=記憶體還在旁邊,但換成便宜大容量的 LPDDR6,靠架構把每一 bit 頻寬用好。
工程重點 1:推論為什麼卡在記憶體頻寬

大模型逐字生成時,每吐一個 token 都要把用到的權重從記憶體讀一遍。所以單一使用者的速度上限,大約是 記憶體頻寬 ÷ 每個 token 要讀的位元組數。作者換算:以總參數 6,710 億、每 token 啟用約 370 億參數的 MoE 模型(DeepSeek-V3 等級)為例,FP4 下每個 token 約讀 18.5 GB。Titania 單顆 2,458 GB/s 的理論上限約每秒 130 個 token;AX8 整台 19.6 TB/s 約 1,060 個。實際會被通訊、KV cache 與利用率打折,但方向很清楚:頻寬決定速度,容量決定塞不塞得下。

工程重點 2:Fractile 賭的是「距離」,本質是 SoIC 式 3D 堆疊

HBM 在 CoWoS 上是並排放,資料要橫跨中介層走幾毫米。Fractile 把 DRAM 直接蓋在運算核心正上方,路徑縮到幾微米,連接點可以鋪滿整個晶片面積,而不是只用晶片邊緣。概念上跟 AMD 3D V-Cache(台積電 SoIC 混合鍵合把 SRAM 疊在 CPU 上)同一家族,只是疊的從 SRAM 換成容量大得多的 DRAM。昨天華為韜定律那篇講的混合鍵合,在這裡變成記憶體的解法。Fractile 沒公布具體頻寬數字與代工夥伴,這兩點要等 2027 年產品。

工程重點 3:Axelera 賭的是「容量」,而且繞開封裝排隊

LPDDR6 單顆頻寬比 HBM 低,但它是手機、AI PC、車用的標準品,走一般封裝,不用排 TSV 堆疊和 CoWoS。美光曾說同樣位元數的 HBM3E 吃掉的晶圓約是 DDR5 的 3 倍,所以同一片晶圓做成標準 DRAM 能多出不少容量。Axelera 的算盤是 MoE 模型總參數大、每次啟用小:作者換算,1.6 兆參數在 FP4 約 800 GB,AX8 的 1 TB 剛好塞得下還留 KV cache 空間,而且整台 5~6 kW 氣冷,舊機房 15 kW 機櫃能放兩台。

工程重點 4:真正的三道關:熱、良率、產能

第一,DRAM 怕熱:JEDEC 規範超過 85°C 就要加倍刷新,漏電也變快;Fractile 把 DRAM 壓在最燙的運算晶片上,熱設計是生死題。第二,良率相乘:堆疊後壞一層就賠整顆,必須先篩出已知良品(KGD)。第三,產能:LPDDR6 一樣出自三星、SK 海力士、美光,只是能多源採購;粉專提到 Fractile 可能找力積電、華邦電這類客製 3D DRAM 廠,目前是業界推測,沒有官方證實。至於台積電:HBM 路線越熱,CoWoS 越吃緊;3D 堆疊路線越熱,SoIC 類技術越吃香,兩邊它都在牌桌上。

還缺什麼/待核

  • Fractile「比現有晶片快 100 倍、能耗省 90%」與 Axelera「每瓦吞吐 7 倍、TCO 20 倍」都是公司說法,Axelera 的數字官方註明為模擬,兩家都還沒有量產實測。
  • Fractile 未公布每顆晶片的頻寬、容量、製程與代工廠。
  • 130/1,060 token/s、800 GB 是作者用公開規格做的理論上限換算,不是實測。
  • 與力積電、華邦電合作屬推測,未見官方消息。

延伸影片

黃仁勳說 AI 的盡頭是電!微型核能 vs 燃料電池,誰能拯救算力荒?黃仁勳說 AI 的盡頭是電!微型核能 vs 燃料電池,誰能拯救算力荒?

Axelera 標榜「不用水冷、舊機房就能跑」,背後就是這支影片講的 AI 用電壓力。

你覺得 2027 年誰會先證明自己:往上疊的 Fractile,還是換記憶體的 Axelera?還是 HBM+CoWoS 根本不會被撼動?留言聊聊。

資料來源:TechCrunch、SiliconANGLE、SiliconReport(引 Reuters、Bloomberg、FT),Balderton 與 Lightspeed 投資公告(2026-11-11);Axelera AI 新聞稿與 Titania 產品頁(2026-11-12);FB 粉專原文。標示「作者換算」者非官方數字。
原始貼文在這:https://www.facebook.com/1147074221177116/posts/1159830179901520
本文由 vkinngworld/@vkinng 整理。半導體新聞每天在粉專拆,歡迎來留言:FB 粉專「PLC」

2026年11月13日 星期五

華為韜定律是什麼?邏輯折疊原理拆解:等效1.4奈米是堆出來的,台積電早就在做

華為韜定律是什麼?邏輯折疊原理拆解:等效1.4奈米是堆出來的,台積電早就在做

華為韜定律是什麼?邏輯折疊原理拆解:等效1.4奈米是堆出來的,台積電早就在做

重點先講:華為的「韜(τ)定律」不是製程突破,而是架構上的替代路線。它的核心技術「邏輯折疊」,本質是把平面電路分成兩層、再用混合鍵合疊起來。密度是真的變高了,但那是投影面積變小,不是電晶體變小。這篇用數字拆給你看,也說清楚台積電在同一條路上走到哪了。

原始貼文在這:FB:華為的韜定律,突破台積電的製程限制了?

發生了什麼

  • 2026 年 5 月 25 日,華為半導體業務部總裁何庭波在 IEEE ISCAS 2026(上海)發表韜定律:以「時間縮微」取代「幾何縮微」,目標 2031 年密度達等效 1.4 奈米。
  • τ 是電路的時間常數(RC 延遲)。邏輯折疊把關鍵路徑上的邏輯分到上下兩層,走線變短、電阻電容變小,訊號更快。
  • 華為公布的麒麟 2026 數字:密度從 155 跳到 238 MTr/mm²(約 +54%)、性能核能效約 +41%、最高頻率約 +13%,而且同一個製程節點。
  • 7 月的 V2 論文補充:晶圓對晶圓混合鍵合,鍵合間距 1.5 µm;目標 2030 年 292、2031 年 400 MTr/mm²。
  • 延伸閱讀:「等效幾奈米」這種說法為什麼要小心?看昨天的A16 埃米製程:1.6 奈米只是名字。
一句話分清楚:
幾何縮微(台積電 N2、A16)=把電晶體本身做小。
邏輯折疊(華為)=電晶體大小不變,把電路摺成兩層。
兩條路可以同時走,但只走第二條,天花板比較低。
工程重點 1:密度是「疊」出來的,所以只拿到 1.54 倍

兩層堆疊,理論上投影面積減半、密度翻倍。實際上 155 → 238 是 1.54 倍,因為上下層要留位置給垂直連接和繞線。這跟台積電研究的 CFET(把 nMOS 疊在 pMOS 上)很像:業界估計 CFET 面積縮小約 1.5 到 2 倍,也到不了完整 2 倍。台積電在 IEDM 2023 已展示 48 nm 閘極間距的 CFET 電晶體,2024 年做出可運作的反相器。所以「立體化」不是華為獨有的點子。

工程重點 2:關鍵在鍵合有多密,華為這點其實不差

華為論文提出「齒比」:鍵合間距 ÷ 頂層金屬間距。齒比越接近 1,上下兩層就越像同一片晶圓的兩層金屬,折疊效果越好。作者換算:1.5 µm 間距約每平方毫米 44 萬個連接點;台積電 SoIC 晶片對晶圓量產間距從 9 µm 進到 6 µm(約 2.8 萬個),2029 年目標 4.5 µm。要公平說:晶圓對晶圓本來就比晶片對晶圓容易做細(台積電也有 SoIC-X 晶圓對晶圓),兩者不能直接比誰強。

工程重點 3:晶圓對晶圓的代價是複合良率

晶圓對晶圓不能先挑好的晶片再疊,壞的上層會連帶毀掉好的下層。作者換算:兩層各 80% 良率,疊完約 64%;各 60% 就剩 36%。華為在受限的 7 奈米級製程上量產,基礎良率越低,這個平方效應越痛。每多疊一層,還要多一輪光刻、薄膜和 CMP,設備和材料用量接近翻倍。

工程重點 4:散熱沒爆,是因為拿速度換電壓

粉專原文擔心多層堆疊熱悶在中間。華為的反駁數據是:同性能下電壓從 1.1 V 降到 0.9 V、功耗 −41%、功率密度 −5.6%。也就是說,它把折疊省下的時間拿去降電壓,而不是全拿來衝頻率。這在手機上合理,但滿載衝頻時熱點怎麼散,還要看實機。台積電的路線則是 N2P、A16 背面供電再加 SoIC,縮 + 堆兩邊一起拿。

還缺什麼/待核

  • 238 MTr/mm²、能效 +41%、功率密度 −5.6% 都是華為自己公布的數字,還沒有獨立拆解實測。
  • 「等效 1.4 奈米」是密度換算,不是製程節點;Omdia 分析師也直說這是封裝式密度,不能和真正的台積電/Intel 1.4 奈米比。
  • 44 萬、2.8 萬連接點與 64%/36% 良率是作者換算,用來說明尺度,不是任何產品實測。
  • 華為論文自己把 EDA 列為最大未解挑戰:設計工具要把兩片晶圓當一顆晶片在單元層級分配。

延伸影片

TSMC晶片堆疊大戰:一次搞懂 SoIC-X、SoIC-P 與 3D IC 封裝的未來TSMC晶片堆疊大戰:一次搞懂 SoIC-X、SoIC-P 與 3D IC 封裝的未來

你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!

你覺得邏輯折疊是真的新路,還是被設備封鎖逼出來的妥協?如果台積電也把 N2 摺成兩層,差距會變多大?留言聊聊。

資料來源:華為官網〈華為發表韬(τ)定律〉(2026-05-25);騰訊新聞〈華為更新韬定律論文〉(V2,2026-07);EE Times Asia;The Register(Omdia 評論);TrendForce;Tom's Hardware〈The current state of Hybrid Bonding in 2026〉;TSMC Research CFET(IEDM 2023/2024);FB 粉專原文。標示「作者換算」者非官方數字。
原始貼文在這:https://www.facebook.com/1147074221177116/posts/1158720626679142
本文由 vkinngworld/@vkinng 整理。這題在粉專討論很熱,歡迎來留言:FB 粉專「PLC」

2026年11月12日 星期四

A16埃米製程是什麼?1.6奈米只是名字:用閘極間距看懂真實尺寸

A16埃米製程是什麼?1.6奈米只是名字:用閘極間距看懂真實尺寸

A16埃米製程是什麼?1.6奈米只是名字:用閘極間距看懂真實尺寸

重點先講:台積電把 1.6 奈米叫成 A16,不是因為電晶體真的縮到 1.6 奈米,而是整個產業換了一把尺。從 28 奈米之後,製程名字就不再對應晶片上任何一個真實尺寸;它是一個「世代代號」,代表比上一代更密、更省電、更快。這篇用真實的間距數字,帶你看名字和物理差了多遠。

原始貼文在這:FB:台積電不叫1.6奈米,改叫A16埃米製程

發生了什麼

  • 單位換算:1 奈米 = 10 埃米(Å),所以 1.6 奈米 = 16 埃米,台積電稱 A16;更下一代 1.4 奈米稱 A14。
  • 第一槍是 Intel:2021 年 7 月把路線圖改名為 Intel 20A、18A,宣告「埃米時代」。台積電在 N2 之後跟進。
  • 時程有變:台積電原本說 A16 在 2026 下半年量產;2026 年技術論壇改口「2026 年製程就緒,但量產看客戶,排在 2027」。A14 為 2028,A13/A12 為 2029。
  • 延伸閱讀:台積電 N2 奈米片怎麼「浮」起來,N2 GAA 奈米片製程解析。
一句話分清楚:
製程名字(N2、A16、18A)=行銷世代代號。
真實尺寸=閘極間距(CPP)、金屬間距(MP)、單位面積電晶體數。
兩者從 28 奈米之後就脫鉤了。
工程重點 1:1.6 奈米大概只排得下 7 個矽原子

矽晶體的原子鍵長約 0.235 奈米,晶格常數約 0.543 奈米。作者換算:1.6 ÷ 0.235 ≈ 6.8,也就是一條真正 1.6 奈米寬的線,大約只有 7 個原子並排。到這個尺度,量子穿隧會讓電子直接「穿牆」漏電,開關根本關不緊。所以沒有人真的在做 1.6 奈米寬的閘極。

工程重點 2:真正的尺寸要看兩個間距

Intel 的 Mark Bohr 在 2017 年就建議用「閘極間距 × 最小金屬間距」來比密度。IEEE 的 IRDS 路線圖(2024 版)把「2 奈米」寫成 閘極間距 48 nm、金屬間距 22 nm。作者換算:48 ÷ 2 = 24,光是閘極間距就是名字的 24 倍;若拿 A16 的 1.6 來比,就是 30 倍。台積電 N3 公開過的數字也是同一個量級(N3 閘極間距 45 nm、N3E 金屬間距 23 nm);N2 的論文則沒有公布間距。

工程重點 3:名字變小,靠的不只是「縮」

既然線寬縮不太動,進步從哪來?N2 換成 GAA 奈米片,閘極四面包住通道;A16 再加上 背面供電 Super Power Rail,把電源線搬到晶圓背面,正面空間留給訊號。台積電官方數字:A16 對比 N2P,同功耗速度 +8–10%、同速度功耗 −15–20%、晶片密度 1.07–1.10 倍。注意這是「混合密度」(50% 邏輯、30% SRAM、20% 類比),不是單純把線縮小。

工程重點 4:那為什麼還要叫 A16?

因為名字是給客戶和市場看的「世代刻度」。從 3、2 往下,再叫 1.6、1.4 很像在擠牙膏;換成埃米,數字又變回整數、往下還有空間。這不代表技術是假的,A16 的效能和功耗進步是真的,只是它來自結構(GAA、背面供電、DTCO),不是「線寬 = 1.6 奈米」。看製程時,請直接比 密度、功耗、效能 三個數字,別比名字。

還缺什麼/待核

  • 台積電沒有公開 N2/A16 的閘極間距與金屬間距;本文的 48/22 nm 是 IRDS 路線圖的通用值,不是台積電實測。
  • A16 量產時程已從 2026 下半年調整為 2027,實際導入看客戶(HPC 為主)。
  • 「約 7 個原子」「24 倍/30 倍」為作者換算,用來說明尺度,不是任何製程的實際線寬。
  • 各家命名不能直接比:Intel 18A、三星 SF2、台積電 N2/A16 的密度要看實際量測報告。

延伸影片

TSMC晶片堆疊大戰:一次搞懂 SoIC-X、SoIC-P 與 3D IC 封裝的未來TSMC晶片堆疊大戰:一次搞懂 SoIC-X、SoIC-P 與 3D IC 封裝的未來

你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!

當線寬縮不動,你覺得下一把尺會是什麼?電晶體密度、每瓦效能,還是乾脆不再用長度命名?留言聊聊。

資料來源:TSMC 官網 HPC 先進製程頁;Tom's Hardware〈TSMC unveils process technology roadmap through 2029〉;SemiEngineering〈TSMC Tech Symposium 2026, By The Numbers〉;Silicon Almanac〈What "2 nm" means〉(IRDS 2024);Intel 2021-07 路線圖;FB 粉專原文。標示「作者換算」者非官方數字。
原始貼文在這:https://www.facebook.com/1147074221177116/posts/1156230876928117
本文由 vkinngworld/@vkinng 整理。這題在粉專討論很熱,歡迎來留言:FB 粉專「PLC」

2026年11月11日 星期三

NPO與CPO差異比較:差的不是距離是等級,台積電COUPE為何是終局

NPO與CPO差異比較:差的不是距離是等級,台積電COUPE為何是終局

NPO與CPO差異比較:差的不是距離是等級,台積電COUPE為何是終局

重點先講:很多人以為 NPO 和 CPO 只是「光模組離晶片近一點或遠一點」。其實兩者差的是製造等級:NPO 還是在 PCB 上做「系統組裝」,CPO 已經跨進「半導體封裝」。這一步跨過去,電訊號從走幾公分變成走幾毫米,交換器的功耗、可靠度、維修方式和供應鏈全部跟著改寫。

原始貼文在這:FB:NPO 跟 CPO,差的不是距離,是「等級」

發生了什麼

  • NVIDIA 與台積電合作的 Spectrum-X Photonics CPO 交換器,採用台積電 COUPE 封裝,已開始出貨給特定夥伴,2026 下半年擴產;NVIDIA 宣稱相較可插拔光模組,功耗效率約 3.5 倍。
  • TrendForce(2026-07)指出 Broadcom 51.2T Bailly CPO 交換器已量產,並點名光引擎良率與先進封裝產能是 CPO 擴產的主要瓶頸。
  • 同時,Broadcom 也推出 VCSEL 版 NPO,主打約 1 pJ/bit 與可單獨更換,NPO 並沒有退場。
  • 延伸閱讀:上一篇我們拆了 CPO 接收端的鍺光偵測器,CPO鍺光偵測器原理。
一張表看懂:
NPO:光引擎與 ASIC 各自封裝 → 同一塊 PCB → 銅線約 1–10 cm → 系統組裝、可單獨更換。
CPO:光引擎與 ASIC 同一個封裝(載板或中介層)→ 微凸塊/TSV → 電訊號約毫米級 → 半導體封裝、壞了不好修。
工程重點 1:真正被縮短的是「電的那一段」

光纖傳幾百公尺都不怕,怕的是光變回電之前那段高速銅線。200G 級 SerDes 在 PCB 上每多走一公分,損耗就往上疊,於是要靠 DSP、Retimer 去補。產業整理資料指出 NPO 的通道損耗可壓在 13 dB 以下;NVIDIA 則說 CPO 把電損耗降到約 4 dB。差幾個 dB,就決定了要不要放那顆耗電的 DSP。

工程重點 2:省下的電,用 pJ/bit 算最清楚

業界常引用的區間是:可插拔模組約 15–20 pJ/bit,CPO 約 5–10 pJ/bit。作者換算(非官方):一台 102.4 Tb/s 交換器的光互連,15 pJ/bit 約 1,536 W,5 pJ/bit 約 512 W,一台就差上千瓦;十萬台規模的 AI 叢集,差距是 MW 級。原貼文提到 NPO 省電約 15–25%、CPO 約 30–50%,屬於粗估區間,實際要看世代與架構。

工程重點 3:「系統組裝」與「半導體封裝」的良率邏輯完全不同

NPO 的光引擎可以先單獨測試、單獨更換,壞了換一塊就好。CPO 則要在封裝前確保每顆光引擎都是 known-good,因為封進去後,一顆光引擎或一排微凸塊出事,可能整顆高價封裝一起報廢。這也是為什麼雷射被刻意留在外面(外部雷射源 ELS):最容易老化的零件不放進封裝裡。

工程重點 4:CPO 和 AI 晶片搶同一條封裝產線

CPO 一旦依賴 COUPE 這類 2.5D/3D 封裝,就得跟 GPU 搶同一批先進封裝產能。TrendForce 把這列為三大瓶頸之一。另一個難點是熱:光學元件怕熱,和幾百瓦的交換晶片零距離,Spectrum-X Photonics 機箱因此採用液冷。這也解釋了為什麼台積電是 CPO 的關鍵,不只是代工晶片,而是把光和電「封」在一起的那個人。

還缺什麼/待核

  • NPO 目前沒有統一的公開 pJ/bit 數字;Broadcom VCSEL NPO 約 1 pJ/bit 屬廠商說法,且多為多模短距離應用,和單模矽光 CPO 不能直接比。
  • NVIDIA 的 3.5 倍是網路層級的整體數字,包含拿掉主機端 Retimer,不只是光模組本身。
  • 本文 1,536 W/512 W 為作者以業界區間換算,非實測值。
  • CPO 的維修模式(換整台交換器或換板)與長期可靠度,仍待大規模部署驗證。

延伸影片

矽光子與 CPO矽光子與 CPO

你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!

NPO 是撐到 CPO 成熟的過渡,還是會長期並存?如果你是資料中心維運,你會選哪一個?留言聊聊。

資料來源:NVIDIA Technical Blog〈Scaling AI Factories with Co-Packaged Optics〉;NVIDIA 2025-03-18 新聞稿;TrendForce 2026-07-27 CPO 報告;Taiwan News 2026-06-04;Broadcom VCSEL NPO 技術文章;FB 粉專原文。標示「作者換算」者非官方數字。
原始貼文在這:https://www.facebook.com/1147074221177116/posts/1156573600227178
本文由 vkinngworld/@vkinng 整理。這題在粉專討論很熱,歡迎來留言:FB 粉專「PLC」

2026年11月10日 星期二

CPO鍺光偵測器原理:矽看不見光,台積電怎麼讓晶片收到訊號

CPO鍺光偵測器原理:矽看不見光,台積電怎麼讓晶片收到訊號

CPO鍺光偵測器原理:矽看不見光,台積電怎麼讓晶片收到訊號

重點先講:CPO 把光引擎塞進交換器封裝裡,但接收端有個物理上的尷尬:矽對通訊波長的紅外光幾乎是透明的。光跑了好幾公尺抵達晶片,矽卻「看不見」它。解法是在矽波導上方長一塊鍺(Ge),讓鍺當晶片的眼睛:把光吸進去、轉成電流,再交給放大器還原成 0 與 1。

原始貼文在這:FB:CPO最尷尬的秘密:矽晶片本身,根本看不見光!

發生了什麼

  • NVIDIA 已宣布採用台積電 COUPE(緊湊型通用光子引擎)光引擎的 Spectrum-X 矽光子交換器進入量產;台積電也表示 COUPE 共封裝方案 2026 年量產。
  • COUPE 用 SoIC 把電子晶片(EIC)面對面疊在 65 nm 矽光晶片(PIC)上,發射端用微環調制器,接收端靠鍺光偵測器(GePD)。
  • 公開簡報列出的 COUPE GePD 規格:110 GHz 頻寬、4.5 nA 暗電流;另有產業整理報告引述響應度約 1.0 A/W。
  • 11/07 我們寫過發射端「矽不會發光、只能外接雷射」;今天補上另一半:接收端「矽也收不到光」。
一句話物理:半導體只吸收能量大於能隙的光子。矽能隙 1.12 eV,截止波長約 1.1 µm;1310 nm 光子只有約 0.95 eV,不夠把矽的電子踢上去。鍺的直接能隙約 0.80 eV(對應約 1550 nm),剛好吃得下 O-band 與 C-band。
工程重點 1:光先在 220 nm 的矽波導裡跑

光從光纖耦合進晶片後,在 SOI 頂層約 220 nm 厚、約 500 nm 寬的矽波導裡傳。矽在這裡的角色是「水管」:正因為它不吸 1310 nm,才能把光低損耗地送到偵測器前面。換句話說,矽看不見光這個缺點,在傳輸段反而是優點。

工程重點 2:鍺塊陷阱——漸逝波把光「吸」上去

偵測區的矽波導上方磊晶一塊鍺。鍺折射率(約 4.2)比矽(約 3.5)高,光場會往高折射率區偏,透過漸逝波耦合一路斜爬進鍺層,邊走邊被吸收。作者估算(非官方):鍺在 1310 nm 的吸收係數約 7,000–9,000 /cm 量級,吸收長度約 1–1.5 µm,所以幾十微米長的鍺塊就能把絕大部分光吃光,同時保持元件小、電容低。

工程重點 3:反向偏壓把電子電洞拉開——頻寬與暗電流的拉鋸

光子被鍺吸收後產生電子與電洞,兩側 P/N 摻雜加反向偏壓,電場把它們迅速拉開,形成微弱的光電流。作者換算:理想響應度上限 R = λ(µm)/1.24,1310 nm 約 1.06 A/W;若實測 1.0 A/W,代表量子效率約 95%。難點在鍺與矽晶格差約 4%,介面會長出穿隧差排,變成漏電路徑——暗電流就是雜訊底。110 GHz 頻寬配 4.5 nA 暗電流,代表空乏區夠薄、缺陷也壓得夠低。

工程重點 4:SoIC 讓 TIA 貼著偵測器——省下的是雷射電

光電流只有微安級,要靠轉阻放大器(TIA)轉成電壓。走線越長、寄生電容越大,TIA 越難放大,雷射就得打更亮。台積電在 ECTC 2024 論文指出,COUPE 的 SoIC 低電容接合提升 TIA 靈敏度,雷射功耗可降 40% 以上。這也接回 11/07 那篇:外接雷射是 CPO 的耗電大戶,接收端越靈敏,雷射就能越省。

還缺什麼/待核

  • COUPE 量產版 GePD 的實際響應度、暗電流分佈與良率,台積電未逐項公開;本文規格來自公開簡報與產業整理。
  • 吸收係數、吸收長度、95% 量子效率均為作者以教科書數值估算,非量測值。
  • 天下雜誌報導台積電的鍺矽感測技術曾登上 Nature,細節以原文為準。
  • 光纖對位、溫控微環、CPO 維修性仍是量產後的真正考驗。

延伸影片

矽光子與 CPO矽光子與 CPO

你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!

矽不會發光、也看不見光,CPO 卻還是用矽當主角。你覺得下一個卡關點是光纖對位、微環溫控,還是良率?留言聊聊。

資料來源:台積電 COUPE 公開規格(Swissphotonics 2025 CPO 簡報整理);IEEE ECTC 2024 COUPE 論文;SemiWiki〈How TSMC Is Wiring the AI Era With Light〉;天下雜誌英文版 2026-08-24 報導;FB 粉專原文。標示「作者估算/換算」者非官方數字。
原始貼文在這:https://www.facebook.com/1147074221177116/posts/1151079287443276
本文由 vkinngworld/@vkinng 整理。這題在粉專討論很熱,歡迎來留言:FB 粉專「PLC」

2026年11月9日 星期一

台積電2T0C記憶體原理:1T1C撞牆後為何改堆氧化物

台積電2T0C記憶體原理:1T1C撞牆後為何改堆氧化物

台積電2T0C記憶體原理:1T1C撞牆後為何改堆氧化物

重點先講:傳聞說「台積電要做 3D DRAM」,先分清兩條路:1T1C(1 電晶體 + 1 電容)對上 2T0C(2 電晶體、0 電容)。前者被立體電容卡住;後者用氧化物甩掉電容,卻換來散熱關卡。公開事實是:台積電仍強調純邏輯代工,而 VLSI 2025 秀出的是後段金屬層上的氧化物 1T1C 測試方案——不是已經量產的 2T0C。

原始貼文在這:FB:台積電真的要做 3D DRAM 了?1T1C 對上 2T0C

發生了什麼

  • 外媒報導台積電評估先進記憶體/3D DRAM;公司對媒體重申核心是 dedicated IC foundry(純晶圓代工)。
  • VLSI 2025:台積電發表 BEOL 氧化物 1T1C 測試晶片——約 0.75 V、保持 >128 ms、讀寫 <8 ns、耐久 >10¹⁴,定位比 SRAM 更密的晶上記憶體。
  • 學術界推進 IGZO 2T0C:2025 Science Advances 展示 8×8 立體陣列,保持 >100 秒。
  • 粉專結論:1T1C 不是不好,是電容快立不上去;2T0C 不是完美,是熱與可靠度變成新戰場。
比喻:1T1C 電容像指甲蓋上的台北 101(深寬比 >50:1)。2T0C 拆掉水塔,改用兩顆氧化物電晶體的閘極寄生電容當小水桶——桶小,但幾乎不漏。
工程重點 1:1T1C 為什麼撞牆

1T1C 靠電容存電荷。面積越縮,電容只能長高,深寬比動輒超過 50:1;再 3D 化往往要把電容側躺進奈米狹縫。矽通道漏電大,每數十毫秒就要 Refresh,讀取還會破壞電荷必須回寫——AI 負載下,頻寬與功耗被這套更新儀式吃掉一大塊。

工程重點 2:2T0C 為什麼像為 AI 訂做

2T0C 乾脆不要實體電容:用 IGZO 等氧化物(能隙約 >3 eV)做電晶體,電荷暫存在閘極寄生電容。關斷漏電極低,保持可拉到數十~數百秒;製程約 300–400°C,適合長在 BEOL 金屬層,單層僅數十奈米。對代工廠,這比較像「在互連上再做電晶體」,不是去賣 DDR 顆粒。

工程重點 3:散熱——毯子蓋在火爐上

氧化物熱導率大約只有矽的 1% 量級。多層 2T0C 堆在數百瓦 GPU 頭頂,就像蓋保溫被;局部一過約 85°C(討論用警戒量級),漏電明顯惡化,「長效不漏」會塌。遷移率也較低,難取代 L1/L2,較適合大容量最後一級晶上快取。

工程重點 4:傳聞、論文、產品要分開

三件事:①台積電對商品 3D DRAM 的公開口徑仍是純代工;②它秀過的是 BEOL 氧化物 1T1C(仍有電容);③2T0C/IGZO 立體陣列 以學術與研發為主,記憶體廠也在氧化物通道佈局多年。PBTS 造成的 Vth 漂移與專利網,都是量產前硬關。詳見FB 原文。

還缺什麼/待核

  • 是否為客戶量產 2T0C/商品 3D DRAM:公司未確認,外媒屬傳聞。
  • VLSI 2025 測試晶片的電容結構、氧化物配方、對接哪個邏輯節點:細節未全公開。
  • 「約 85°C」與「熱導率約矽的 1%」為量級/討論用,非台積電產品規格。

延伸影片

記憶體為什麼一直漲?揭秘那個害你買不起電腦的「幕後黑手」|HBM vs DDR 產能大戰記憶體為什麼一直漲?揭秘那個害你買不起電腦的「幕後黑手」|HBM vs DDR 產能大戰

TSMC晶片堆疊大戰:一次搞懂 SoIC-X、SoIC-P 與 3D IC 封裝的未來TSMC晶片堆疊大戰:一次搞懂 SoIC-X、SoIC-P 與 3D IC 封裝的未來

你覺得晶上記憶體最後走 2T0C,還是 BEOL 1T1C?留言聊聊。

資料來源:台積電 foundry 定位之媒體回應;2025 VLSI 氧化物 BEOL 1T1C 公開報導(0.75 V、>128 ms、<8 ns、>10¹⁴);Science Advances 2025 IGZO 2T0C 陣列;DRAM 1T1C 深寬比/Refresh 產業背景;FB 粉專原文。
原始貼文在這:https://www.facebook.com/1147074221177116/posts/1154136300470908
本文由 vkinngworld/@vkinng 整理。這題在粉專討論很熱,歡迎來留言:FB 粉專「PLC」

2026年11月8日 星期日

台積電N2 GAA奈米片原理:懸空通道怎麼做出來不塌

台積電N2 GAA奈米片原理:懸空通道怎麼做出來不塌

台積電N2 GAA奈米片原理:懸空通道怎麼做出來不塌

重點先講:台積電 N2 是第一代 Nanosheet GAA(環繞式閘極)。電子顯微鏡剖面上,通道像「浮」在半空——但那不是魔術,而是一連串材料選擇性的工程:先長一疊 Si/SiGe 千層派,再把 SiGe 精準掏空,最後用原子層沉積把閘極灌進只有幾奈米的縫。最致命的一步是「拆鷹架」:只要用到液體,表面張力就能把奈米片吸黏報廢。

原始貼文在這:FB:台積電 N2 GAA 的奈米片,是怎麼「浮」起來的?

發生了什麼

  • 台積電 N2 已於 2025 年第四季進入量產,是公司首個 GAA 奈米片節點;官方對比 N3E:同功耗速度 +10–15%,或同速度功耗 −25–30%,邏輯密度約 1.15 倍。
  • 為何告別 FinFET:鰭片閘極只包三面,縮到 3 nm 以下,底部漏電與短通道效應壓不住;奈米片把通道橫躺、多層堆疊,閘極四面包覆,靜電控制更強。
  • N2 另有 NanoFlex:同一晶片可混用不同高度的標準單元,在效能與面積之間微調——這是奈米片寬度可調帶來的設計彈性。
  • 台積電沒公開 N2 的片數與厚度;業界展示(如 IBM 2021 年 2 nm 晶片)多為 3 層堆疊、單片約數奈米厚,本文以此為量級參考。
切面錯覺:垂直電流方向切通道中央,2D 剖面看不到支撐點;沿電流方向看,奈米片兩端牢牢接在源極/汲極磊晶上——像懸索橋,橋墩在兩端,中段騰空給閘極包覆。
工程重點 1:千層派——Si 和 SiGe 交替磊晶

製程起點是在矽晶圓上交替磊晶純 Si(未來的通道)與 SiGe(臨時鷹架),再一起蝕刻成鰭狀長條。關鍵在於兩種材料晶格相近、能連續長得很平整,但化學性質不同:後面的每一步,都靠「咬 SiGe、不碰 Si」的選擇性。Ge 濃度、層厚、退火熱預算都會改變後續蝕刻速率——文獻指出退火越熱,Ge 擴散越嚴重,SiGe 反而越難蝕。

工程重點 2:Inner Spacer——先築防火牆再拆鷹架

在源極/汲極磊晶長出之前,先從側面把 SiGe 往內咬掉幾奈米,形成凹槽,再填入氮化矽類介電質,這就是 Inner Spacer。它有兩個工作:電性上隔開未來的金屬閘極與源汲極,降低寄生電容、防短路;機械上,它是奈米片懸空時的「支撐墊」——模擬研究顯示 Inner Spacer 從 3 nm 變薄到 1 nm,奈米片中段形變會放大約 1.8 倍。凹槽深度在每一層要一致,學界報告氣相蝕刻能把各層差異壓到 1 nm 以下。

工程重點 3:拆鷹架為什麼一定要「乾」

Channel release 是把 SiGe 全部移除、讓 Si 片懸空的步驟。若用濕式藥水,乾燥時液體留在片與片之間,毛細力會把奈米片拉在一起黏死(stiction)。作者估算(非官方):拉普拉斯壓力 ΔP ≈ 2γ/g,水的 γ ≈ 0.072 N/m、縫隙 g ≈ 10 nm,ΔP ≈ 14 MPa,約 140 大氣壓,壓在幾奈米厚的矽片上根本撐不住。所以產業走向非電漿的氣相乾式蝕刻:文獻報告 SiGe/Si 選擇比約 56–87,甚至 IBM 在 IEDM 2019 發表過對 SiGe25% 達 150:1 的乾蝕刻;矽片單側損失可壓在 1 nm 以下。

工程重點 4:ALD 原子級灌漿——閘極要鑽進縫裡

鷹架拆完,奈米片之間只剩數奈米空隙。接下來要在每一片的上下左右長出界面氧化層、high-k 介電與功函數金屬,厚度誤差以埃計——只有 ALD(原子層沉積)這種一次只長一層原子的方式辦得到。如果最下層片長得比上層薄,各片閾值電壓就會不一致,這也是 GAA 良率比 FinFET 難拉的原因之一。粉專把這四步濃縮成「疊積木、築防火牆、拆鷹架、原子級灌漿」:FB 原文。

還缺什麼/待核

  • 台積電未公開 N2 的奈米片層數、厚度與 channel release 實際化學品;本文製程描述來自公開文獻與業界通用 GAA 流程。
  • 14 MPa 毛細壓力為作者以理想潤濕、10 nm 縫隙的數量級估算,非量測值。
  • 選擇比 56–87、150:1 為不同研究團隊的實驗結果,不代表台積電產線數據。
  • N2 良率與成本台積電未逐一揭露,外界數字多為供應鏈傳聞。

延伸影片

TSMC晶片堆疊大戰:一次搞懂 SoIC-X、SoIC-P 與 3D IC 封裝的未來TSMC晶片堆疊大戰:一次搞懂 SoIC-X、SoIC-P 與 3D IC 封裝的未來

你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!

你覺得 GAA 量產最難的是「拆鷹架」還是「ALD 灌漿」?或是下一代 CFET 會更難?留言聊聊。

資料來源:台積電 N2 公開規格與量產說明;IEDM 2019 SiGe 乾式選擇性蝕刻論文;MDPI Nanomaterials 2026 Inner Spacer 與 channel release 氣相蝕刻研究;MDPI Electronics 2021 奈米片機械穩定性模擬;FB 粉專原文。標示「作者估算」者非官方數字。
原始貼文在這:https://www.facebook.com/1147074221177116/posts/1150392860845252
本文由 vkinngworld/@vkinng 整理。這題在粉專討論很熱,歡迎來留言:FB 粉專「PLC」

2026年11月7日 星期六

CPO矽光子原理:為何矽不會發光,只能外掛InP雷射

CPO矽光子原理:為何矽不會發光,只能外掛InP雷射

CPO矽光子原理:為何矽不會發光,只能外掛InP雷射

重點先講:矽做得出奈米電晶體,卻發不出有效雷射光——因為它是間接帶隙半導體:電子復合時能量多變熱、少變光子。這是材料物理,不是台積電製程極限。所以今天的 Gen-1 CPO(Broadcom/台積電 COUPE 路徑)選擇「燈泡掛外面」:前面板可替換的 CW InP 外部雷射源(ELS)+光纖進 PIC+片上調變器刻 0/1。理想派想把 III–V 發光材料直接貼上矽,但 CTE、熱與老化仍挡量產。

原始貼文在這:FB:矽不會發光與 CPO 外掛雷射

發生了什麼

  • 物理底線:矽=間接帶隙 → 輻射復合效率極低。矽光子仍可在約 220 nm SOI 波導引導/調變近紅外光;偵測器常用 Ge-on-Si;雷射增益介質需 III–V(典型 InP)。
  • Gen-1 CPO 架構:連續波(CW)外部雷射源模組(常為 InP)裝在前面板/可替換 ELS;光纖耦合進 PIC;片上調變器(microring/MZM/EAM)刻資料。雷射遠離高熱交換 ASIC;可熱插拔,不必整顆 CPO 報廢。
  • 台積電 COUPE/CPO 公開敘事:CPO 量產約 2H2026;矽光子占光收發器市場份額 2027 年 >50%(副總 Hsu 引述見 Taipei Times/SEMICON Taiwan 報導)。點名瓶頸:雷射、光纖、連接器、光偵測器、封裝、光耦合、測試。
  • NVIDIA Spectrum-X/Quantum-X CPO 產業報導(2026):外掛 CW InP;一則對 Quantum-X800 類架構描述為多個 SiPh 引擎共用較少高功率 CW 雷射(約 4 引擎:1 雷射)相對可插拔每通道 EML——雷射顆數下降,高功率 CW InP 需求上升。Lumentum 曾談 CW 雷射供需缺口/溢價(財報評論)。
  • 未來:台積電路徑圖(TechOrange/TechNews)提後期 CPO-OI 可在 COUPE 背面整合調變/放大/雷射——無量產日。III–V 鍵合上矽仍是理想,CTE/熱/可靠度挡量產。
一句話對照:主流派=「燈泡掛外面」(ELS+光纖+片上調變);理想派=「把發光材料貼上矽」(III–V 異質整合)。前者已在 Gen-1 CPO 落地;後者研究熱、量產冷。
工程重點 1:間接帶隙不是「製程沒做好」

直接帶隙(InP、GaAs)電子與電洞可對齊動量直接復合發光;矽導帶底與價帶頂不在同一 k 點,復合常需聲子協助,效率極差——電流大多變熱。矽可當優秀波導與調變平台(約 220 nm SOI),卻不當本征雷射增益介質。把「CPO 外掛雷射」講成製程妥協,是把物理誤讀成工程偷懶。

工程重點 2:外掛 ELS=用耦合損換可維修性與熱隔離

CW InP 放前面板可替換模組,代價是光纖耦合損與對準公差;好處是遠離交換 ASIC 熱區,老化/故障可換 ELS、不必報廢整顆 CPO。作者定性:ASIC 表面約 85–100°C、InP 偏好較涼接面時,毫米級共封裝會惡化臨界電流與壽命——熱動機方向說明,非量測 ΔT。粉專概括「燈泡掛外面」,方向正確。

工程重點 3:雷射「顆數」下降,不等於 InP 需求下降

可插拔常是每 lane 一顆 EML;CPO 共享 CW 架構可用少數高功率 CW InP 餵多個 SiPh 引擎。作者示意:1 顆分給 4 引擎 → 顆數約 −75%,分光前每顆約須 4× 光功率(非規格書)。故產業可同時說「顆數變少」與「高功率 CW InP 供需緊/溢價」(Lumentum 等財報評論)。

工程重點 4:異質整合是理想,CTE 與可靠度是帳單

InP 增益層鍵合上矽可縮光路、減耦合件,簡報很愛畫。實務上 III–V/矽 CTE 失配帶來應變與裂紋,加上高溫與老化,量產良率與現場壽命仍是硬牆。台積電路徑圖的後期 CPO-OI(光學中介層整合調變/放大/雷射)目前沒有公開量產日;在那之前 Gen-1「外掛 ELS」仍是可出貨路徑。粉專對照「燈泡掛外面」與「發光材料貼上矽」:FB 原文。

還缺什麼/待核

  • CPO 2H2026 量產、SiPh 2027 市占 >50% 為公開敘事/報導引述,非本文審計的出貨數字。
  • 「4 引擎:1 雷射」為特定架構報導描述,不宜外推成所有 CPO 產品的固定比。
  • CPO-OI 整合雷射路徑圖無量產日;異質鍵合量產時程仍屬研究/產業展望。
  • 作者熱動機與 4× 功率示意為定性/數量級,非實驗室量測或供應商規格書。

延伸影片

矽光子與 CPO矽光子與 CPO:光怎麼走進交換晶片

你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!

你覺得「燈泡掛外面」還能撐幾代 CPO,還是 III–V 異質整合會先破局?留言告訴我。

資料來源:間接帶隙/矽光子基礎物理;台積電 COUPE/CPO 公開敘事與 Taipei Times/SEMICON Taiwan 對 Hsu 副總引述;NVIDIA Spectrum-X/Quantum-X CPO 產業報導;Lumentum 等對 CW 雷射供需之財報評論;TechOrange/TechNews 對台積電 CPO-OI 路徑圖整理;FB 粉專原文。標示「作者估算」「報導稱」「公開敘事」者非官方出貨稽核數字。
本文由 vkinngworld/@vkinng 整理。這題在粉專討論很熱,歡迎來留言:FB 粉專「PLC」

2026年11月6日 星期五

台積電CoWoP架構解析:砍掉ABF載板後,AI封裝省什麼又犧牲什麼

台積電CoWoP架構解析:砍掉ABF載板後,AI封裝省什麼又犧牲什麼

台積電CoWoP架構解析:砍掉ABF載板後,AI封裝省什麼又犧牲什麼

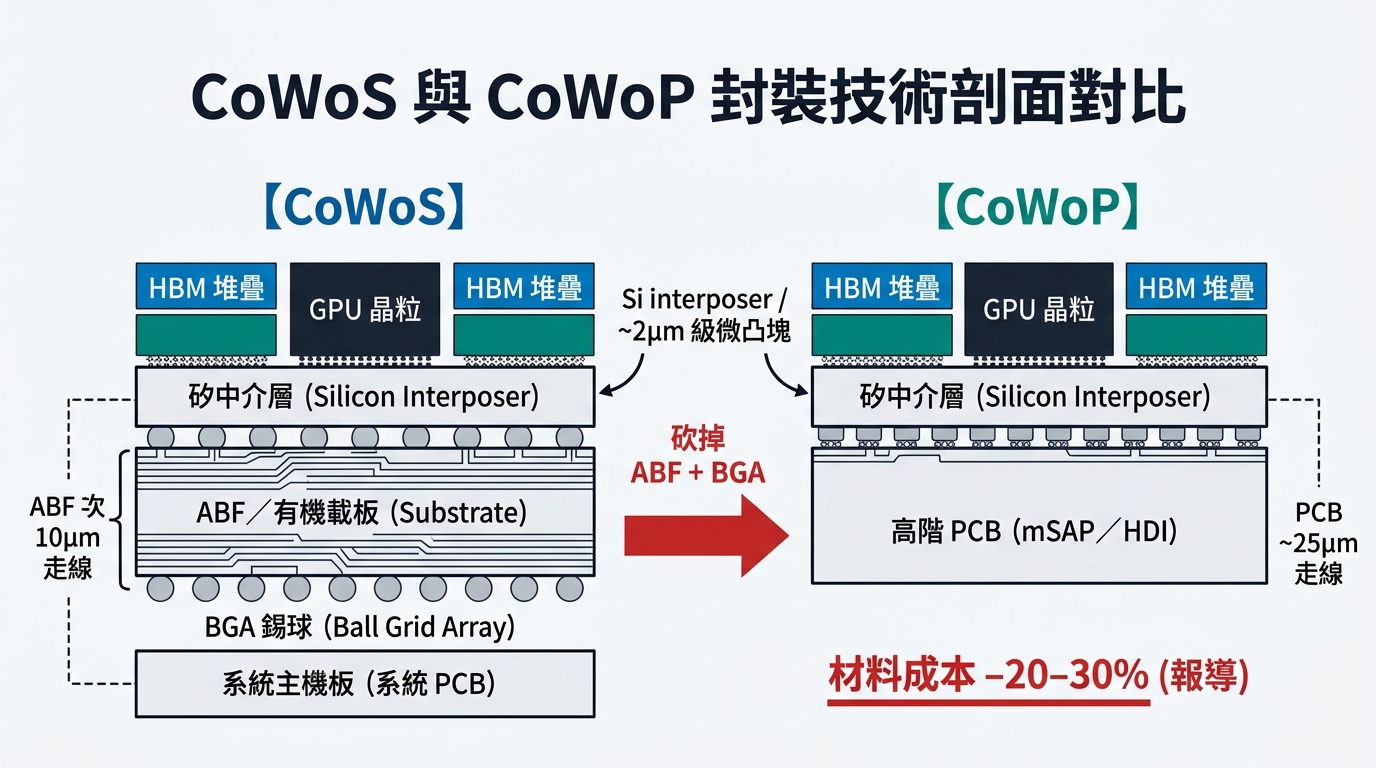
重點先講:CoWoS 最貴、最卡的一層,常常不是矽中介層本身,而是底下那片 ABF/BT 封裝載板加上 BGA。供應鏈近期討論的 CoWoP(Chip-on-Wafer-on-PCB),核心構想很直白:GPU 與 HBM 之間仍靠矽中介層做微米級互連,但整疊「Chip-on-Wafer」改直接落到高階 PCB,砍掉傳統封裝載板與錫球。省材料、縮路徑、簡供應鏈——聽起來很香;線寬變粗、翹曲與良率帳單,則是另一面。

發生了什麼

  • 定義(產業分析用語,非台積電正式產品發表):CoWoP 保留矽中介層服務 GPU↔HBM 細間距;以 mSAP/HDI 等級高階 PCB 取代 ABF/BT 載板+BGA(DigiTimes、工商時報等供應鏈報導)。
  • 報導宣稱效益:砍掉 ABF+BGA 後,封裝材料成本約可降 20–30%;電氣路徑可縮短約 40%(DigiTimes 一則);熱路徑不必再穿過 ABF;PCB 產能與週期相對較有彈性。
  • 工業壓力:OCP APAC 2026,台積電先進封裝負責人何軍指出 CoWoS 5.5 倍光罩已量產、良率約 98–99%,並點名 ABF 載板與記憶體仍是瓶頸——這正是「跳過載板」構想有人聽的背景(第三方整理)。
  • 市場傳:輝達可能以 CoWoS+CoWoP 雙軌應對 Rubin GR150(約 2026 年 10 月供應鏈傳聞);JPM/MS/Ming-Chi 等分析師對中期大量採用偏懷疑。台積電自己較清楚的公開敘事仍是 CoPoS 面板級封裝(約 2026 試產、2028 量產量級),CoWoP 相對仍屬早期概念。
  • 粉專整理/市場傳:矽中介層單價約 US$15k 量級、14 層 ABF 良率壓力、報價上漲約 20%、Rubin 長達約 52 週交期——本文當「市場合成」引用,非財報稽核數字。10 月法說電話會議亦有先進封裝需求「very large gap」的評論轉述。
一句話對照:CoWoS = Chip-on-Wafer-on-Substrate(ABF/有機載板+BGA);CoWoP = Chip-on-Wafer-on-PCB(載板層被高階板取代)。兩者都還有矽中介層,不是「不要中介層」。
工程重點 1:砍掉的是載板層,不是微凸塊

GPU 與 HBM 之間的微凸塊、矽中介層上的細線,仍是 CoWoS 家族的價值核心——間距在數微米量級。CoWoP 沒有宣稱要改這一段,而是動「中介層往下」:原本要再過一層高密度 ABF 載板、再用 BGA 焊到系統板;現在改成中介層(或經有限重佈)直接落到可量產的高階 PCB。供應鏈邏輯是:ABF 產能與週期卡得緊,PCB 廠能補;材料帳上少買一片昂貴載板與一層錫球。

工程重點 2:材料省 20–30%,不代表總成本同比例下降

報導口徑是「封裝材料成本約 −20–30%」。作者示意:若 ABF+BGA 本來就占 CoWoS BOM 材料裡的顯著一截,砍掉它們,落在「材料」這欄看到 20–30% 並不奇怪;但同一批報導也提到 PCB 製程費可能約 2 倍於一般板,再加上翹曲補償、測試與重工。因此「材料 −20–30%」≠「整顆模組總成本 −20–30%」。在沒有公開 BOM 拆解前,只能把區間當供應鏈宣稱,不能當審計數字。

工程重點 3:線寬代價——板側 I/O 變粗約 ≥2.5 倍

ABF 載板可做到次 10µm 級線寬/線距;高階 PCB 的 mSAP 常見約 25/25 µm。作者估算示意:25 ÷ 10 = 2.5,也就是板側路由 pitch 粗約 ≥2.5 倍(示意,非量測)。結果是:中介層上的細腳距,下到板端必須做較粗的重佈或較少的直接 I/O——訊號完整性、電源平面分割、逃逸走線都會重新設計。DigiTimes 提到電氣路徑可縮約 40%,方向合理(少一層載板與 BGA 高度),但那是報導數字,不是本文在實驗室量到的。

工程重點 4:翹曲、CTE 與良率,才是真正的工程帳單

矽中介層 CTE 接近矽;有機 ABF 與 PCB 的 CTE 都高得多。把大面積 CoW 直接貼到 PCB,翹曲與熱循環應力不會 magically 消失,只是「應力落在哪一層、用什麼 underfill/補強」換了位置。良率若掉幾個百分點,重工(尤其已貼好 HBM 的昂貴堆疊)很快吃掉材料省下來的錢。這也是分析師對「Rubin 世代就大量走 CoWoP」偏保守的原因:技術演示與供應鏈備援是一回事,吃掉主力產能是另一回事。粉專原文也從載板瓶頸角度聊過這條線:FB 原文:CoWoP 與載板壓力。

還缺什麼/待核

  • 台積電尚未把 CoWoP 列為與 CoWoS/CoPoS 同級的正式量產平台名稱;本文依 DigiTimes/工商時報等供應鏈報導整理,屬產業分析。
  • 「材料 −20–30%」「路徑 −40%」「PCB 製程費約 2×」皆為報導宣稱,缺公開 BOM 與實測驗證。
  • 輝達 Rubin GR150 雙軌、52 週交期、中介層約 US$15k 等為粉專整理/市場傳,非公司財報或規格書。
  • 與 CoPoS(面板、約 2028)的關係:兩者都在紓解載板/產能壓力,但製程與時程不同,不宜混為同一產品。

延伸影片

你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!

SoIC 先進封裝原理SoIC 立體堆疊:比 CoWoS 更近一步的互連

你覺得 CoWoP 會先當 CoWoS 產能備援,還是真能在 Rubin 世代吃掉主力訂單?留言告訴我。

資料來源:DigiTimes/工商時報等供應鏈報導(CoWoP 定義與成本/路徑宣稱)、OCP APAC 2026 何軍演講第三方整理(5.5× 光罩、良率、ABF/記憶體瓶頸)、分析師評論(JPM/MS/Ming-Chi 等對中期量產態度)、台積電 CoPoS 公開敘事、10 月法說先進封裝需求評論轉述、FB 粉專整理。標示「作者估算」「報導稱」「市場傳」者非官方數字。
本文由 vkinngworld/@vkinng 整理。這題在粉專討論很熱,歡迎來留言:FB 粉專「PLC」

2026年11月5日 星期四

CoWoS熱翹曲原理:輝達B200為何非液冷不可?關鍵是溫差,不是溫度

CoWoS熱翹曲原理:輝達B200為何非液冷不可?關鍵是溫差,不是溫度

重點先講:大家都說 B200 要液冷是因為「太燙」。這只說對一半。真正讓工程師睡不著的,是台積電 CoWoS 封裝裡好幾種材料熱膨脹不一樣:每次 GPU 從待機衝到滿載再降回來,封裝就被「拉一次、放一次」。液冷把溫度壓低、把溫差壓小,等於幫焊點和微凸塊延壽。

發生了什麼

  • 功耗:HGX B200 每顆 GPU 可設定到 1kW(NVIDIA 文件);GB200 NVL72 裡的 B200 最高約 1,200W、GB300 NVL72 的 B300 約 1,400W,而且 NVL72 沒有氣冷版(Barrack AI 整理)。
  • 2024 年 Blackwell 延遲時,SemiAnalysis 指出 CoWoS-L 裡 GPU 晶粒、矽橋、有機中介層與基板之間的熱膨脹係數(CTE)失配會造成翹曲,輝達因此改了上層金屬與凸塊設計(SemiAnalysis、3D InCites)。
  • 2026 年 10 月 OCP APAC,台積電先進封裝負責人何軍提到:材料越擠越近,「不匹配的梯度」累積應力;超過 5.5 倍光罩後,散熱和翹曲難度非線性上升,還舉了元件測試沒事、裝進客戶系統卻出現崩角與 low-k 脫層的案例(Simple Tech Trend 整理)。
工程重點 1:熱流密度,氣冷已經追不上

B200 是兩顆接近光罩極限的大晶粒。我假設兩顆合計約 1,600mm²,1,200W 平均下來約 0.75 W/mm²,也就是 75 W/cm²(作者估算,熱點還會更高)。這個熱流要穿過晶粒、導熱介面材料(TIM)、蓋板再到散熱器,每一層都有熱阻。氣冷的空氣比熱和導熱太差,只能靠更大的鰭片和更快的風扇硬撐;冷板液冷讓水直接貼著蓋板帶走熱,同樣功耗下晶片溫度可以低很多。

工程重點 2:真正的殺手是 CTE 失配

矽約 2.6 ppm/K,有機基板約 15 ppm/K,差約 12 ppm/K。5.5 倍光罩約 4,720mm²,等於邊長約 69mm 的正方形,角落離中心約 49mm。作者粗算:升溫 55K 時,矽和基板在角落的「自由伸縮差」約 32µm;壓到 35K 只剩約 20µm(未計底部填充膠等拘束,只說明量級)。對間距只有幾十微米的微凸塊來說,這是每天上百次的拉扯。焊點熱疲勞常用 Coffin-Manson 關係,以指數約 2 粗估,溫差從 55K 降到 35K,壽命約多 2.5 倍(作者估算)。

工程重點 3:溫度梯度,比平均溫度更危險

同一個封裝裡,GPU 核心最燙,旁邊的 HBM 堆疊相對冷,基板更冷。溫度不均勻,封裝就不是均勻膨脹,而是扭成「馬鞍形」或「笑臉、哭臉」形。這就是何軍說的「梯度」問題:平均溫度看起來還好,局部應力卻可能讓 low-k 介電層脫層、晶粒邊角崩裂。液冷的優勢在於熱容量大、流量可調,能把熱點和周邊的溫差拉近,而不只是把最高溫壓下來。

工程重點 4:下一步是把水道做進矽裡

台積電在 ECTC 2025 發表矽整合微冷卻器(IMC-Si),在 3.3 倍光罩的 CoWoS-R 上,用 40°C 進水、每分鐘 10 公升,可散掉最高 3.4kW(約 2.5 W/mm²);密封膠設計成可容忍封裝翹曲,並通過 2,000 次溫度循環測試(IEEE ECTC 2025)。這是展示技術,不代表 Blackwell 量產已採用。但方向很清楚:封裝越大,散熱就越要「長」在封裝裡。粉專 10/25 也用一句話講過這件事:FB 原文:B200 為什麼一定要用液冷。

還缺什麼/待核

  • 輝達和台積電沒有公開 B200 的實際翹曲量、凸塊間距或可靠度規格,本文溫差與壽命數字都是作者用公開材料參數做的量級估算。
  • 2024 年的 CTE 失配說法來自分析機構與媒體,輝達官方只承認改過光罩提升良率。
  • OCP 演講內容引用自第三方整理,非台積電官方逐字稿。

延伸影片

你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!

揭秘 1mm 固態散熱黑科技:xMEMS 原理深度解析手機發燙救星?揭秘 1mm「固態散熱」黑科技

你覺得下一代 AI 晶片會走冷板、浸沒式,還是直接把水道做進矽裡?留言告訴我。

資料來源:NVIDIA HGX 文件、SemiAnalysis、3D InCites、IEEE ECTC 2025、OCP APAC 2026 整理、Barrack AI。標示「作者估算」者為本文自行計算,非官方數字。
本文由 vkinngworld/@vkinng 整理。這題在粉專討論很熱,歡迎來留言:FB 粉專「PLC」

2026年11月4日 星期三

台積電CoPoS面板級封裝原理:化圓為方多塞1.8倍,第一代可能沒有玻璃

台積電CoPoS面板級封裝原理:化圓為方多塞1.8倍,第一代可能沒有玻璃

重點先講:台積電 CoPoS(Chip-on-Panel-on-Substrate)的核心不是「玻璃」,而是「化圓為方」:把 CoWoS 用的圓形 12 吋晶圓載板,換成 310×310mm 的方形面板,讓越來越大的 AI 封裝不再浪費邊角。玻璃?第一代很可能只出現在「暫時載板」上。

發生了什麼

  • 10 月 15 日第三季法說會,魏哲家表示 5.5 倍光罩尺寸的先進封裝已量產、良率優異,並朝更大的 9 倍、14 倍推進;同時發展 CoPoS,希望未來給客戶「合理的成本降幅」,也坦言後段產能確實有些短缺(鉅亨網)。
  • TrendForce 指出台積電 CoPoS 已統一採用 310×310mm 面板;2026 年是設備材料驗證期,2027 年試產,2028 下半年量產(TrendForce)。DigiTimes 則估 2029 年前不會量產(Investing.com 轉述)。
  • 經濟日報 8 月報導,嘉義先進封測七廠(AP7)的 CoPoS 首條線已完工運轉,技術與良率約需一年穩定(Seoul Economic Daily 轉述)。魏哲家在股東會也說,量要「非常大」還要兩到三年(經濟日報)。
工程重點 1:化圓為方,到底多塞幾顆?

以 1 個光罩 858mm² 計,5.5 倍約 4,720mm²。我假設中介層是 69×69mm 正方形、晶圓留 3mm 邊、面板留 5mm 邊,用程式窮舉擺法:300mm 圓晶圓最多 9 顆,310×310mm 面板 16 顆,約 1.8 倍;換成約 9 倍光罩(88×88mm),是 5 顆對 9 顆(皆為作者估算)。面板面積只比晶圓大 36%,多出來的主要是「形狀紅利」:方塊越大,圓邊浪費越兇。天下雜誌引用 Yole 的例子也是同一個方向:7 個變 16 個、利用率約 45% 升到 81%(天下雜誌)。

工程重點 2:第一代 CoPoS 可能「零玻璃」

很多人把 CoPoS 等同玻璃基板,但天下雜誌英文版訪問的資深封裝專家認為,第一代 CoPoS 很可能採「零玻璃」方案,唯一的玻璃是製程中可重複使用的暫時載板(glass carrier)(CommonWealth)。流程是在玻璃載板上做有機 RDL、上晶片、封膠,再拆掉載板切成單顆。真正把玻璃留在產品裡的「玻璃核心基板」,TrendForce 估 2030 年後才較可能商用(TrendForce)。

工程重點 3:翹曲帳,面板越大越難

矽的熱膨脹係數約 2.6 ppm/K,常見有機基板約 15~17 ppm/K。作者粗算:從約 260°C 回流降到室溫(ΔT≈235K),12 ppm/K 的差異在 88mm 封裝上就是約 0.26mm 的「自由伸縮差」,放大到 300mm 面板約 0.87mm(未計材料拘束,只說明量級)。這就是為什麼台積電先從 310mm 小面板切入,也是玻璃(CTE 可調到接近矽)被寄予厚望的原因。粉專上次用「烤魷魚紙板 vs 鋼化玻璃」講過這件事:FB 原文:玻璃基板到底神在哪。

工程重點 4:TGV 打孔與檢測,是真正的良率關卡

要讓玻璃留在產品裡,就得打玻璃穿孔(TGV)。目前主流是皮秒/飛秒雷射改質再濕蝕刻成孔;雷射、鍍銅或熱製程產生的微裂紋可能延伸到相鄰孔,影響電性與良率,所以檢測會是量產關鍵(TrendForce)。設備面也是新戰場:面板線與 300mm 製程不相容,單條 FOPLP 線投資約 1~2 億美元(Digital Today 引 Semiconductor Engineering)。

還缺什麼/待核

  • 量產時間:TrendForce 2028 下半、DigiTimes 2029、摩根士丹利估可能提前到 2028,台積電官方沒給日期。
  • 首發客戶是否為輝達、AP7 之外是否動用友達中科廠區,都還是媒體報導,未經證實。
  • 面板尺寸尚未統一:台積電 310×310mm,其他業者有 515×510、600×600mm 等規格。

延伸影片

你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!

TSMC晶片堆疊大戰:SoIC-X、SoIC-P 與 3D IC 封裝TSMC晶片堆疊大戰:SoIC-X、SoIC-P 與 3D IC 封裝

你覺得 CoPoS 最先卡關的會是翹曲、TGV 打孔,還是設備投資?留言告訴我。

資料來源:鉅亨網 10/15 法說會、TrendForce 6/17、TrendForce 9/21、CommonWealth 7/6、天下雜誌、Seoul Economic Daily 8/11、DigiTimes via Investing.com。標示「作者估算」者為本文自行計算,非官方數字。
本文由 vkinngworld/@vkinng 整理。這題在粉專討論很熱,歡迎來留言:FB 粉專「PLC」

2026年11月3日 星期二

台積電2奈米翻車了嗎?驍龍5GHz發熱降頻原因解析:製程、封裝與功率密度

台積電2奈米翻車了嗎?驍龍5GHz發熱降頻原因解析:製程、封裝與功率密度

重點先講:「台積電 2 奈米翻車」這個說法太重了。公開資訊顯示的是:高通把手機晶片拉到 5GHz 之後,持續高負載下的散熱跟不上,問題比較像「設計取捨+封裝+手機散熱」,而不是製程良率出事。這篇延伸我在粉專的貼文 〈台積電 2nm 翻車?高通 8EE6 狂飆 5GHz〉,把傳聞和工程事實分開來看。

發生了什麼

  • 台積電官方:N2 是第一代奈米片(GAA)電晶體,2025 年第四季已在新竹、高雄量產,良率良好(TSMC 2nm 頁面)。
  • N2 對比 N3E:同功耗速度 +10~15%,或同速度功耗 −25~30%,混合設計密度約 1.15 倍(Tom's Hardware 整理)。
  • 韓國《首爾經濟》10 月 16 日報導:三星 Galaxy S27 Ultra 內測中,驍龍 8 Elite Extreme Gen 6 溫度多次超過門檻、持續負載時降頻,三星要求高通在 10 月中前改善(WebProNews 整理)。
  • 高通回應:「沒有系統性的散熱問題」,10 月 20 日再確認這句話也涵蓋 Extreme 版。Gen 6 兩顆超大核時脈 5.0GHz。
  • 另一項測試:改用 Offset PoP 封裝後,到達 105°C 門檻要超過 15 分鐘,上一代傳統 PoP 約 6 分 30 秒(T客邦)。

一句話:製程像把引擎換成更省油的新款,但你同時把轉速從 4,600 拉到 5,000 轉,還把引擎塞進更小的引擎室,省下來的油很快就被燒回去,熱也更難散。

工程點 1:省下的 25~30%,為什麼被吃回去?

CMOS 動態功耗大約是 P ≈ α·C·V²·f。頻率 f 要往上拉,通常電壓 V 也得一起加。我自己用假設算一下(非官方數據):超大核從約 4.6GHz 拉到 5.0GHz(+8.7%),若電壓同時要加 6%,功耗變成 1.087 × 1.06² ≈ 1.22 倍。也就是說,N2 在「同速度」能省的 25~30%,大部分被「拉高頻率」用掉了。跑分漂亮,手機外殼的熱卻沒少多少。

工程點 2:密度變高,熱流密度跟著變高

N2 混合設計密度約是 N3E 的 1.15 倍。如果一顆核心消耗的功率差不多,面積卻縮小約 13%,每平方毫米的發熱(W/mm²)就約增加 15%。熱不怕總量大,怕集中:熱點溫度一衝上門檻,溫控就會降頻保護晶片。這是先進製程的共同課題,不只台積電,三星 2 奈米一樣要面對。

工程點 3:Offset PoP,把 DRAM 從熱點上方挪開

手機 SoC 傳統用 PoP(Package on Package),LPDDR 記憶體直接疊在處理器正上方,等於在火爐上蓋一床棉被。Offset PoP 把記憶體位置錯開,讓處理器熱點能更直接接觸散熱路徑。報導中到 105°C 門檻的時間從約 6.5 分鐘拉長到 15 分鐘以上,約 2.3 倍,代表封裝確實有幫助,但持續數十分鐘的遊戲或錄影仍可能撞到溫度牆。

工程點 4:最後一關是手機本身

晶片能撐多久,最後看整機:均熱板面積、石墨片、機身材質和廠商的溫控曲線。同一顆晶片,不同品牌手機的持續效能差很多。過去幾代驍龍旗艦首發機也常偏熱,多半靠韌體更新調整功耗曲線。所以「降頻」比較像系統調校問題,不等於製程失敗。

還缺什麼/待核

  • 三星內測沒有公開溫度、降頻幅度等具體數據,目前無法獨立驗證。
  • 網路流傳的「黑屏、縮缸」說法,我找不到可信的公開來源,先當傳聞看。
  • Gen 6 用的是 N2 還是 N2P,各報導說法不一,以高通正式規格為準。
  • 上面 1.22 倍是我用假設電壓算的示意,不是實測。

延伸影片

手機發燙救星?揭秘 1mm「固態散熱」黑科技:xMEMS 原理深度解析
▶ 手機發燙救星?揭秘 1mm「固態散熱」黑科技:xMEMS 原理深度解析

TSMC晶片堆疊大戰:一次搞懂 SoIC-X、SoIC-P 與 3D IC 封裝的未來
▶ TSMC晶片堆疊大戰:一次搞懂 SoIC-X、SoIC-P 與 3D IC 封裝的未來

你覺得手機晶片該繼續追 5GHz、6GHz,還是乾脆把頻率降下來換持續效能?

這題在粉專討論很熱,歡迎來留言:PLC 粉專

想自己量手機充電、發熱時的實際功率,或出門重度使用要補電,可以參考:

FNIRSI FNB-C2 USB PD 3.1 Type-C 快充測試儀 電壓電流表

FNIRSI FNB-C2 USB PD 3.1 Type-C 快充測試儀 電壓電流表

Anker A1664 MagGo 10000mAh Qi2 30W 超薄磁吸行動電源

Anker A1664 MagGo 10000mAh Qi2 30W 超薄磁吸行動電源

本文含蝦皮分潤連結,透過連結購買我會獲得少量回饋,不影響你的價格。

vkinngworld|@vkinng|資料來源:TSMC、Tom's Hardware、WebProNews、T客邦

2026年11月2日 星期一

輝達為什麼一直缺貨?台積電CoWoS產能瓶頸解析:月產12萬片還不夠

輝達為什麼一直缺貨?台積電CoWoS產能瓶頸解析:月產12萬片還不夠

重點先講:輝達 GPU 一直缺貨,瓶頸不在台積電的 4 奈米晶圓,而在後段的 CoWoS 先進封裝。這篇延伸我在粉專的貼文 〈輝達為什麼一直缺貨?〉,用公開報導的數字把瓶頸拆開。

發生了什麼

  • 台積電 CoWoS 月產能:2025 年約 7 萬片 → 2026 年底約 12~14 萬片(TrendForce、DIGITIMES 估約 12.7 萬片)。
  • 輝達預訂 2026 年約 80~85 萬片,超過台積 CoWoS 全年產能的一半;博通約 20~24 萬片居次,AMD 第三。
  • 供需缺口:2026 年估約 20%,年底可望收斂到約 10%,2027 年再改善。
  • 台積電開始把 CoW 前段也外包給日月光、矽品等 OSAT(TrendForce 引 ETNews)。

一句話:晶圓是麵粉,CoWoS 是把麵團、內餡(HBM)包成一顆包子的機台。麵粉再多,包子機不夠,店門口還是排隊。

工程點 1:為什麼一定要 CoWoS?

AI GPU 需要每秒數 TB 的記憶體頻寬,只能把 HBM 堆疊放到 GPU 旁邊幾毫米內,透過矽中介層上上萬條微細走線連接。一般 PCB 載板線寬做不到,所以 GPU 和 HBM 必須先在晶圓上「縫」好(CoW),再上載板(WoS)。

工程點 2:中介層越大,一片晶圓切得越少

新一代 GPU 封裝面積越做越大,CoWoS-L 已走到數倍光罩尺寸。一片 12 吋晶圓能放的中介層數量跟著變少,所以就算「月產片數」成長近一倍,能出貨的 GPU 顆數並沒有等比例增加。這就是產能數字看起來很大、市場仍喊缺的原因。

工程點 3:HBM 也在搶

每顆封裝要配 6~8 顆以上的 HBM 堆疊,記憶體廠的 HBM 產能同樣吃緊,報導指 Micron 2026 年 HBM 已售罄。封裝和記憶體任一邊卡住,整顆 GPU 都出不來。

工程點 4:解方是分流與新技術

台積電一邊擴建南科 AP8、把嘉義 AP7 部分產線轉做 CoWoS,一邊把 CoW 外包給 OSAT;非台積陣營 2026 年底月產能也從原估 2.6 萬片上調到約 4 萬片。長期則看更大尺寸的 CoWoS 和面板級封裝。

還缺什麼/待核

  • 以上產能與分配都是供應鏈與研究機構估計,台積電未正式公布客戶分配。
  • 若 H200 等產品能出貨中國,輝達訂單可能再上修,缺口會再擴大。

延伸影片

你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!
▶ 你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!

記憶體為什麼一直漲?HBM vs DDR 產能大戰
▶ 記憶體為什麼一直漲?HBM vs DDR 產能大戰

你覺得輝達缺貨會在 2027 年解除,還是 AI 需求會繼續把缺口撐開?

這題在粉專討論很熱,歡迎來留言:PLC 粉專

vkinngworld|@vkinng|資料來源:DIGITIMES、TrendForce、TrendForce/ETNews