2026年11月5日 星期四

CoWoS熱翹曲原理:輝達B200為何非液冷不可?關鍵是溫差,不是溫度

CoWoS熱翹曲原理:輝達B200為何非液冷不可?關鍵是溫差,不是溫度

重點先講:大家都說 B200 要液冷是因為「太燙」。這只說對一半。真正讓工程師睡不著的,是台積電 CoWoS 封裝裡好幾種材料熱膨脹不一樣:每次 GPU 從待機衝到滿載再降回來,封裝就被「拉一次、放一次」。液冷把溫度壓低、把溫差壓小,等於幫焊點和微凸塊延壽。

發生了什麼

  • 功耗:HGX B200 每顆 GPU 可設定到 1kW(NVIDIA 文件);GB200 NVL72 裡的 B200 最高約 1,200W、GB300 NVL72 的 B300 約 1,400W,而且 NVL72 沒有氣冷版(Barrack AI 整理)。
  • 2024 年 Blackwell 延遲時,SemiAnalysis 指出 CoWoS-L 裡 GPU 晶粒、矽橋、有機中介層與基板之間的熱膨脹係數(CTE)失配會造成翹曲,輝達因此改了上層金屬與凸塊設計(SemiAnalysis、3D InCites)。
  • 2026 年 10 月 OCP APAC,台積電先進封裝負責人何軍提到:材料越擠越近,「不匹配的梯度」累積應力;超過 5.5 倍光罩後,散熱和翹曲難度非線性上升,還舉了元件測試沒事、裝進客戶系統卻出現崩角與 low-k 脫層的案例(Simple Tech Trend 整理)。
工程重點 1:熱流密度,氣冷已經追不上

B200 是兩顆接近光罩極限的大晶粒。我假設兩顆合計約 1,600mm²,1,200W 平均下來約 0.75 W/mm²,也就是 75 W/cm²(作者估算,熱點還會更高)。這個熱流要穿過晶粒、導熱介面材料(TIM)、蓋板再到散熱器,每一層都有熱阻。氣冷的空氣比熱和導熱太差,只能靠更大的鰭片和更快的風扇硬撐;冷板液冷讓水直接貼著蓋板帶走熱,同樣功耗下晶片溫度可以低很多。

工程重點 2:真正的殺手是 CTE 失配

矽約 2.6 ppm/K,有機基板約 15 ppm/K,差約 12 ppm/K。5.5 倍光罩約 4,720mm²,等於邊長約 69mm 的正方形,角落離中心約 49mm。作者粗算:升溫 55K 時,矽和基板在角落的「自由伸縮差」約 32µm;壓到 35K 只剩約 20µm(未計底部填充膠等拘束,只說明量級)。對間距只有幾十微米的微凸塊來說,這是每天上百次的拉扯。焊點熱疲勞常用 Coffin-Manson 關係,以指數約 2 粗估,溫差從 55K 降到 35K,壽命約多 2.5 倍(作者估算)。

工程重點 3:溫度梯度,比平均溫度更危險

同一個封裝裡,GPU 核心最燙,旁邊的 HBM 堆疊相對冷,基板更冷。溫度不均勻,封裝就不是均勻膨脹,而是扭成「馬鞍形」或「笑臉、哭臉」形。這就是何軍說的「梯度」問題:平均溫度看起來還好,局部應力卻可能讓 low-k 介電層脫層、晶粒邊角崩裂。液冷的優勢在於熱容量大、流量可調,能把熱點和周邊的溫差拉近,而不只是把最高溫壓下來。

工程重點 4:下一步是把水道做進矽裡

台積電在 ECTC 2025 發表矽整合微冷卻器(IMC-Si),在 3.3 倍光罩的 CoWoS-R 上,用 40°C 進水、每分鐘 10 公升,可散掉最高 3.4kW(約 2.5 W/mm²);密封膠設計成可容忍封裝翹曲,並通過 2,000 次溫度循環測試(IEEE ECTC 2025)。這是展示技術,不代表 Blackwell 量產已採用。但方向很清楚:封裝越大,散熱就越要「長」在封裝裡。粉專 10/25 也用一句話講過這件事:FB 原文:B200 為什麼一定要用液冷。

還缺什麼/待核

  • 輝達和台積電沒有公開 B200 的實際翹曲量、凸塊間距或可靠度規格,本文溫差與壽命數字都是作者用公開材料參數做的量級估算。
  • 2024 年的 CTE 失配說法來自分析機構與媒體,輝達官方只承認改過光罩提升良率。
  • OCP 演講內容引用自第三方整理,非台積電官方逐字稿。

延伸影片

你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!

揭秘 1mm 固態散熱黑科技:xMEMS 原理深度解析手機發燙救星?揭秘 1mm「固態散熱」黑科技

你覺得下一代 AI 晶片會走冷板、浸沒式,還是直接把水道做進矽裡?留言告訴我。

資料來源:NVIDIA HGX 文件、SemiAnalysis、3D InCites、IEEE ECTC 2025、OCP APAC 2026 整理、Barrack AI。標示「作者估算」者為本文自行計算,非官方數字。
本文由 vkinngworld/@vkinng 整理。這題在粉專討論很熱,歡迎來留言:FB 粉專「PLC」

2026年11月4日 星期三

台積電CoPoS面板級封裝原理:化圓為方多塞1.8倍,第一代可能沒有玻璃

台積電CoPoS面板級封裝原理:化圓為方多塞1.8倍,第一代可能沒有玻璃

重點先講:台積電 CoPoS(Chip-on-Panel-on-Substrate)的核心不是「玻璃」,而是「化圓為方」:把 CoWoS 用的圓形 12 吋晶圓載板,換成 310×310mm 的方形面板,讓越來越大的 AI 封裝不再浪費邊角。玻璃?第一代很可能只出現在「暫時載板」上。

發生了什麼

  • 10 月 15 日第三季法說會,魏哲家表示 5.5 倍光罩尺寸的先進封裝已量產、良率優異,並朝更大的 9 倍、14 倍推進;同時發展 CoPoS,希望未來給客戶「合理的成本降幅」,也坦言後段產能確實有些短缺(鉅亨網)。
  • TrendForce 指出台積電 CoPoS 已統一採用 310×310mm 面板;2026 年是設備材料驗證期,2027 年試產,2028 下半年量產(TrendForce)。DigiTimes 則估 2029 年前不會量產(Investing.com 轉述)。
  • 經濟日報 8 月報導,嘉義先進封測七廠(AP7)的 CoPoS 首條線已完工運轉,技術與良率約需一年穩定(Seoul Economic Daily 轉述)。魏哲家在股東會也說,量要「非常大」還要兩到三年(經濟日報)。
工程重點 1:化圓為方,到底多塞幾顆?

以 1 個光罩 858mm² 計,5.5 倍約 4,720mm²。我假設中介層是 69×69mm 正方形、晶圓留 3mm 邊、面板留 5mm 邊,用程式窮舉擺法:300mm 圓晶圓最多 9 顆,310×310mm 面板 16 顆,約 1.8 倍;換成約 9 倍光罩(88×88mm),是 5 顆對 9 顆(皆為作者估算)。面板面積只比晶圓大 36%,多出來的主要是「形狀紅利」:方塊越大,圓邊浪費越兇。天下雜誌引用 Yole 的例子也是同一個方向:7 個變 16 個、利用率約 45% 升到 81%(天下雜誌)。

工程重點 2:第一代 CoPoS 可能「零玻璃」

很多人把 CoPoS 等同玻璃基板,但天下雜誌英文版訪問的資深封裝專家認為,第一代 CoPoS 很可能採「零玻璃」方案,唯一的玻璃是製程中可重複使用的暫時載板(glass carrier)(CommonWealth)。流程是在玻璃載板上做有機 RDL、上晶片、封膠,再拆掉載板切成單顆。真正把玻璃留在產品裡的「玻璃核心基板」,TrendForce 估 2030 年後才較可能商用(TrendForce)。

工程重點 3:翹曲帳,面板越大越難

矽的熱膨脹係數約 2.6 ppm/K,常見有機基板約 15~17 ppm/K。作者粗算:從約 260°C 回流降到室溫(ΔT≈235K),12 ppm/K 的差異在 88mm 封裝上就是約 0.26mm 的「自由伸縮差」,放大到 300mm 面板約 0.87mm(未計材料拘束,只說明量級)。這就是為什麼台積電先從 310mm 小面板切入,也是玻璃(CTE 可調到接近矽)被寄予厚望的原因。粉專上次用「烤魷魚紙板 vs 鋼化玻璃」講過這件事:FB 原文:玻璃基板到底神在哪。

工程重點 4:TGV 打孔與檢測,是真正的良率關卡

要讓玻璃留在產品裡,就得打玻璃穿孔(TGV)。目前主流是皮秒/飛秒雷射改質再濕蝕刻成孔;雷射、鍍銅或熱製程產生的微裂紋可能延伸到相鄰孔,影響電性與良率,所以檢測會是量產關鍵(TrendForce)。設備面也是新戰場:面板線與 300mm 製程不相容,單條 FOPLP 線投資約 1~2 億美元(Digital Today 引 Semiconductor Engineering)。

還缺什麼/待核

  • 量產時間:TrendForce 2028 下半、DigiTimes 2029、摩根士丹利估可能提前到 2028,台積電官方沒給日期。
  • 首發客戶是否為輝達、AP7 之外是否動用友達中科廠區,都還是媒體報導,未經證實。
  • 面板尺寸尚未統一:台積電 310×310mm,其他業者有 515×510、600×600mm 等規格。

延伸影片

你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!

TSMC晶片堆疊大戰:SoIC-X、SoIC-P 與 3D IC 封裝TSMC晶片堆疊大戰:SoIC-X、SoIC-P 與 3D IC 封裝

你覺得 CoPoS 最先卡關的會是翹曲、TGV 打孔,還是設備投資?留言告訴我。

資料來源:鉅亨網 10/15 法說會、TrendForce 6/17、TrendForce 9/21、CommonWealth 7/6、天下雜誌、Seoul Economic Daily 8/11、DigiTimes via Investing.com。標示「作者估算」者為本文自行計算,非官方數字。
本文由 vkinngworld/@vkinng 整理。這題在粉專討論很熱,歡迎來留言:FB 粉專「PLC」

2026年11月3日 星期二

台積電2奈米翻車了嗎?驍龍5GHz發熱降頻原因解析:製程、封裝與功率密度

台積電2奈米翻車了嗎?驍龍5GHz發熱降頻原因解析:製程、封裝與功率密度

重點先講:「台積電 2 奈米翻車」這個說法太重了。公開資訊顯示的是:高通把手機晶片拉到 5GHz 之後,持續高負載下的散熱跟不上,問題比較像「設計取捨+封裝+手機散熱」,而不是製程良率出事。這篇延伸我在粉專的貼文 〈台積電 2nm 翻車?高通 8EE6 狂飆 5GHz〉,把傳聞和工程事實分開來看。

發生了什麼

  • 台積電官方:N2 是第一代奈米片(GAA)電晶體,2025 年第四季已在新竹、高雄量產,良率良好(TSMC 2nm 頁面)。
  • N2 對比 N3E:同功耗速度 +10~15%,或同速度功耗 −25~30%,混合設計密度約 1.15 倍(Tom's Hardware 整理)。
  • 韓國《首爾經濟》10 月 16 日報導:三星 Galaxy S27 Ultra 內測中,驍龍 8 Elite Extreme Gen 6 溫度多次超過門檻、持續負載時降頻,三星要求高通在 10 月中前改善(WebProNews 整理)。
  • 高通回應:「沒有系統性的散熱問題」,10 月 20 日再確認這句話也涵蓋 Extreme 版。Gen 6 兩顆超大核時脈 5.0GHz。
  • 另一項測試:改用 Offset PoP 封裝後,到達 105°C 門檻要超過 15 分鐘,上一代傳統 PoP 約 6 分 30 秒(T客邦)。

一句話:製程像把引擎換成更省油的新款,但你同時把轉速從 4,600 拉到 5,000 轉,還把引擎塞進更小的引擎室,省下來的油很快就被燒回去,熱也更難散。

工程點 1:省下的 25~30%,為什麼被吃回去?

CMOS 動態功耗大約是 P ≈ α·C·V²·f。頻率 f 要往上拉,通常電壓 V 也得一起加。我自己用假設算一下(非官方數據):超大核從約 4.6GHz 拉到 5.0GHz(+8.7%),若電壓同時要加 6%,功耗變成 1.087 × 1.06² ≈ 1.22 倍。也就是說,N2 在「同速度」能省的 25~30%,大部分被「拉高頻率」用掉了。跑分漂亮,手機外殼的熱卻沒少多少。

工程點 2:密度變高,熱流密度跟著變高

N2 混合設計密度約是 N3E 的 1.15 倍。如果一顆核心消耗的功率差不多,面積卻縮小約 13%,每平方毫米的發熱(W/mm²)就約增加 15%。熱不怕總量大,怕集中:熱點溫度一衝上門檻,溫控就會降頻保護晶片。這是先進製程的共同課題,不只台積電,三星 2 奈米一樣要面對。

工程點 3:Offset PoP,把 DRAM 從熱點上方挪開

手機 SoC 傳統用 PoP(Package on Package),LPDDR 記憶體直接疊在處理器正上方,等於在火爐上蓋一床棉被。Offset PoP 把記憶體位置錯開,讓處理器熱點能更直接接觸散熱路徑。報導中到 105°C 門檻的時間從約 6.5 分鐘拉長到 15 分鐘以上,約 2.3 倍,代表封裝確實有幫助,但持續數十分鐘的遊戲或錄影仍可能撞到溫度牆。

工程點 4:最後一關是手機本身

晶片能撐多久,最後看整機:均熱板面積、石墨片、機身材質和廠商的溫控曲線。同一顆晶片,不同品牌手機的持續效能差很多。過去幾代驍龍旗艦首發機也常偏熱,多半靠韌體更新調整功耗曲線。所以「降頻」比較像系統調校問題,不等於製程失敗。

還缺什麼/待核

  • 三星內測沒有公開溫度、降頻幅度等具體數據,目前無法獨立驗證。
  • 網路流傳的「黑屏、縮缸」說法,我找不到可信的公開來源,先當傳聞看。
  • Gen 6 用的是 N2 還是 N2P,各報導說法不一,以高通正式規格為準。
  • 上面 1.22 倍是我用假設電壓算的示意,不是實測。

延伸影片

手機發燙救星?揭秘 1mm「固態散熱」黑科技:xMEMS 原理深度解析
▶ 手機發燙救星?揭秘 1mm「固態散熱」黑科技:xMEMS 原理深度解析

TSMC晶片堆疊大戰:一次搞懂 SoIC-X、SoIC-P 與 3D IC 封裝的未來
▶ TSMC晶片堆疊大戰:一次搞懂 SoIC-X、SoIC-P 與 3D IC 封裝的未來

你覺得手機晶片該繼續追 5GHz、6GHz,還是乾脆把頻率降下來換持續效能?

這題在粉專討論很熱,歡迎來留言:PLC 粉專

想自己量手機充電、發熱時的實際功率,或出門重度使用要補電,可以參考:

FNIRSI FNB-C2 USB PD 3.1 Type-C 快充測試儀 電壓電流表

FNIRSI FNB-C2 USB PD 3.1 Type-C 快充測試儀 電壓電流表

Anker A1664 MagGo 10000mAh Qi2 30W 超薄磁吸行動電源

Anker A1664 MagGo 10000mAh Qi2 30W 超薄磁吸行動電源

本文含蝦皮分潤連結,透過連結購買我會獲得少量回饋,不影響你的價格。

vkinngworld|@vkinng|資料來源:TSMC、Tom's Hardware、WebProNews、T客邦

2026年11月2日 星期一

輝達為什麼一直缺貨?台積電CoWoS產能瓶頸解析:月產12萬片還不夠

輝達為什麼一直缺貨?台積電CoWoS產能瓶頸解析:月產12萬片還不夠

重點先講:輝達 GPU 一直缺貨,瓶頸不在台積電的 4 奈米晶圓,而在後段的 CoWoS 先進封裝。這篇延伸我在粉專的貼文 〈輝達為什麼一直缺貨?〉,用公開報導的數字把瓶頸拆開。

發生了什麼

  • 台積電 CoWoS 月產能:2025 年約 7 萬片 → 2026 年底約 12~14 萬片(TrendForce、DIGITIMES 估約 12.7 萬片)。
  • 輝達預訂 2026 年約 80~85 萬片,超過台積 CoWoS 全年產能的一半;博通約 20~24 萬片居次,AMD 第三。
  • 供需缺口:2026 年估約 20%,年底可望收斂到約 10%,2027 年再改善。
  • 台積電開始把 CoW 前段也外包給日月光、矽品等 OSAT(TrendForce 引 ETNews)。

一句話:晶圓是麵粉,CoWoS 是把麵團、內餡(HBM)包成一顆包子的機台。麵粉再多,包子機不夠,店門口還是排隊。

工程點 1:為什麼一定要 CoWoS?

AI GPU 需要每秒數 TB 的記憶體頻寬,只能把 HBM 堆疊放到 GPU 旁邊幾毫米內,透過矽中介層上上萬條微細走線連接。一般 PCB 載板線寬做不到,所以 GPU 和 HBM 必須先在晶圓上「縫」好(CoW),再上載板(WoS)。

工程點 2:中介層越大,一片晶圓切得越少

新一代 GPU 封裝面積越做越大,CoWoS-L 已走到數倍光罩尺寸。一片 12 吋晶圓能放的中介層數量跟著變少,所以就算「月產片數」成長近一倍,能出貨的 GPU 顆數並沒有等比例增加。這就是產能數字看起來很大、市場仍喊缺的原因。

工程點 3:HBM 也在搶

每顆封裝要配 6~8 顆以上的 HBM 堆疊,記憶體廠的 HBM 產能同樣吃緊,報導指 Micron 2026 年 HBM 已售罄。封裝和記憶體任一邊卡住,整顆 GPU 都出不來。

工程點 4:解方是分流與新技術

台積電一邊擴建南科 AP8、把嘉義 AP7 部分產線轉做 CoWoS,一邊把 CoW 外包給 OSAT;非台積陣營 2026 年底月產能也從原估 2.6 萬片上調到約 4 萬片。長期則看更大尺寸的 CoWoS 和面板級封裝。

還缺什麼/待核

  • 以上產能與分配都是供應鏈與研究機構估計,台積電未正式公布客戶分配。
  • 若 H200 等產品能出貨中國,輝達訂單可能再上修,缺口會再擴大。

延伸影片

你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!
▶ 你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!

記憶體為什麼一直漲?HBM vs DDR 產能大戰
▶ 記憶體為什麼一直漲?HBM vs DDR 產能大戰

你覺得輝達缺貨會在 2027 年解除,還是 AI 需求會繼續把缺口撐開?

這題在粉專討論很熱,歡迎來留言:PLC 粉專

vkinngworld|@vkinng|資料來源:DIGITIMES、TrendForce、TrendForce/ETNews

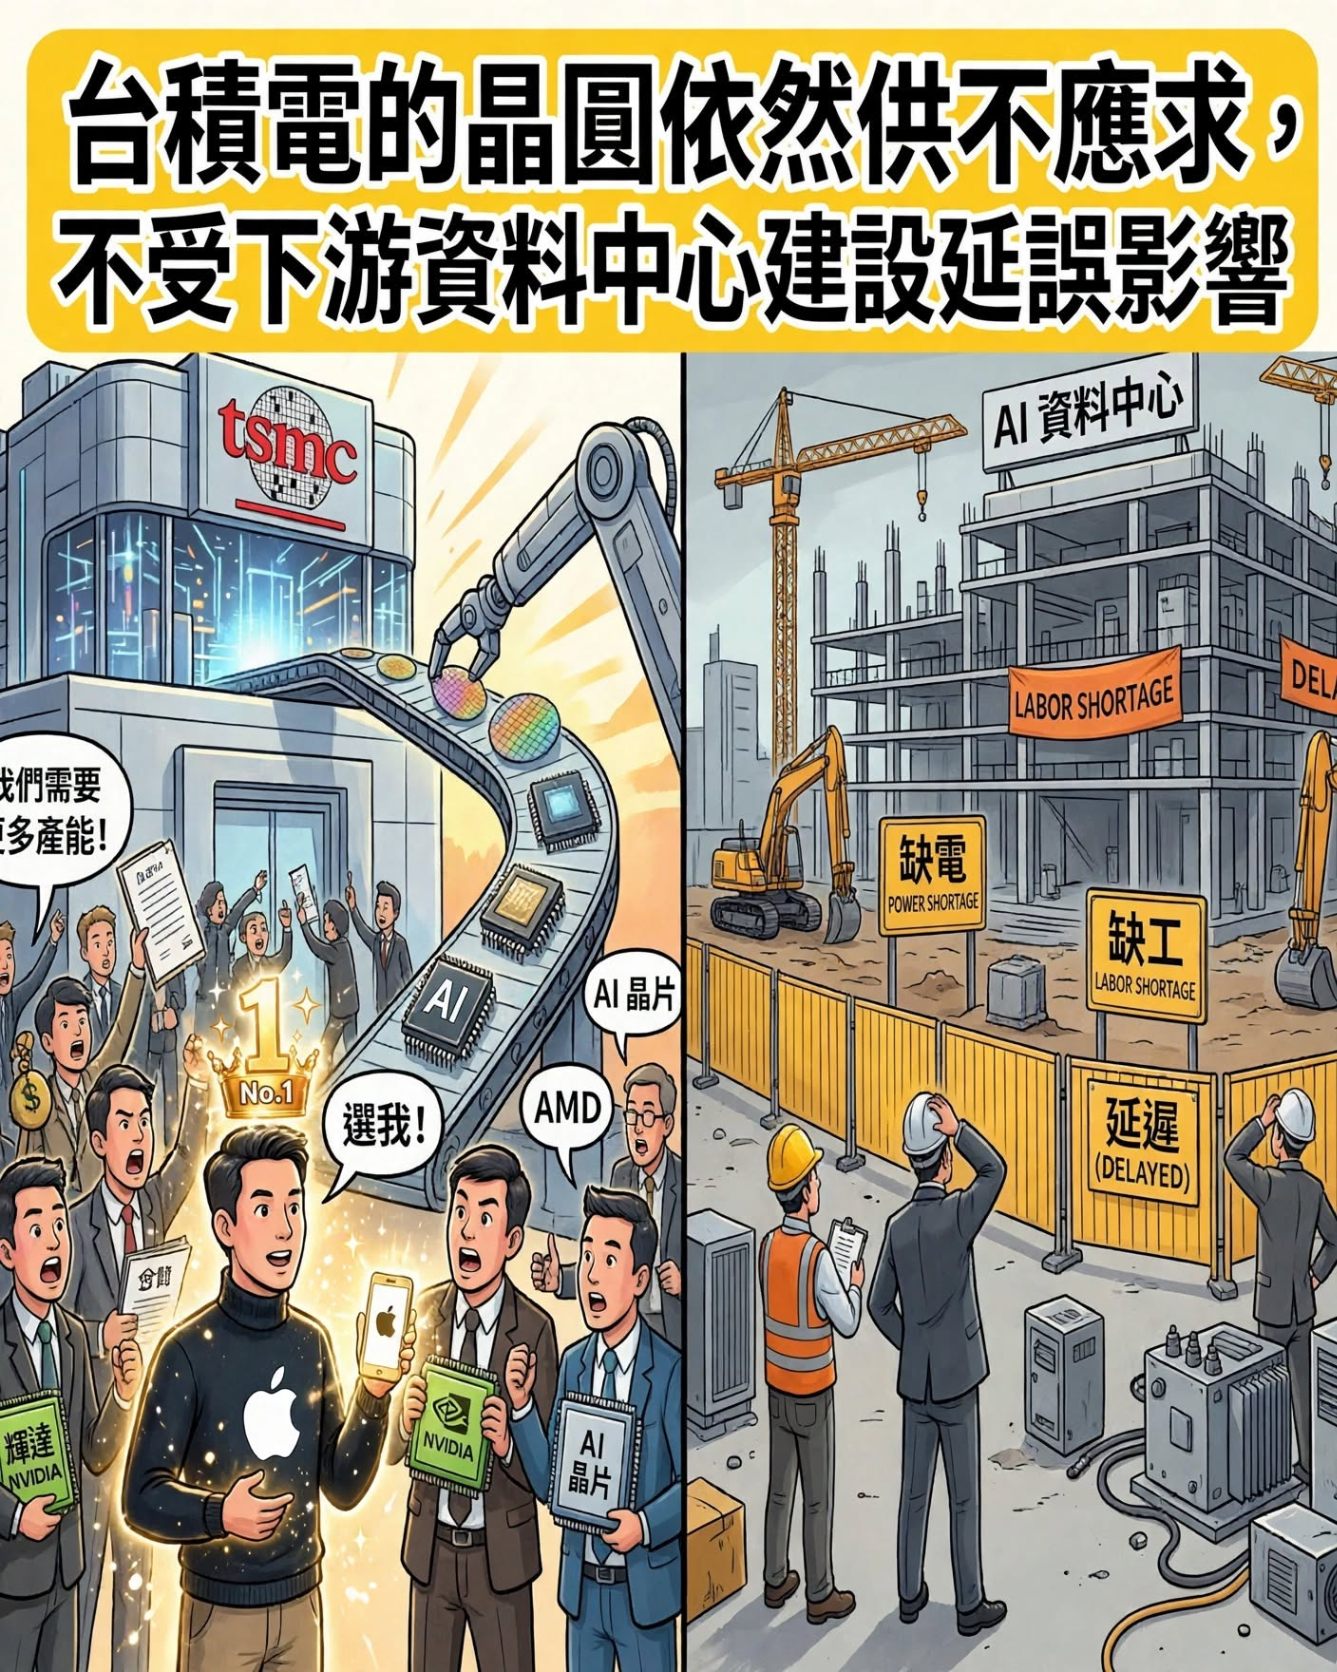
台達電被庫存燙到,台積電會跟著倒楣嗎?一張圖看懂 AI 供應鏈兩端的命運分岔

台達電庫存 vs 台積電過路費

重點先講:粉專這則貼文(FB 原文)用一張對比圖問了一個關鍵問題:AI 資料中心一路延遲,做電源的台達電被庫存燙到,那上游的台積電會跟著倒楣嗎?答案是:不會,而且兩者的命運差別不是運氣,是商業模式——一個賣設備、要押庫存;一個收過路費、出貨即收錢。這篇把機制拆開來看。

發生了什麼

  • AI 資料中心工地貼滿「缺電、缺工、延遲」:土建和電力許可一再順延,設備到了現場也裝不上去。
  • 台達電的電源櫃、變壓器其實早就做好了,但現場進不了場,只能堆在倉庫——庫存天數一拉長,會計就開始認列跌價損失。
  • 同一時間,台積電門口排隊的是輝達、AMD、Apple:先進製程產能滿載,晶圓用噴的一樣出貨。

待核提醒:貼文裡的「90 天一到就認賠」是幫助理解的簡化說法。會計上的實際機制是:存貨以成本與淨變現價值孰低衡量,一旦價格或需求下修、週轉天數拉長,就須評估認列存貨跌價損失,並沒有統一的「90 天規則」。各家公司財務政策不同,數字請以財報為準。

工程重點 1:卡住台達電的是「時間差」,不是技術

電源設備是照專案時程提前生產的——變壓器交期動輒一年起,等現場通知才開始做根本來不及。所以設備廠必須押庫存賭工期,這是本業的物理特性。問題出在資料中心的延遲多半來自電網排隊、許可證、人力這些設備廠完全控制不了的外部變數:產品做好了,工地上卻連電都還沒接。設備在倉庫裡放一天,就是一天的資金成本與跌價風險。

工程重點 2:台積電賣的是過路費

台積電的模式剛好把庫存風險移掉了大半:先進製程採預付款+產能預訂,客戶先付錢鎖產能,晶圓一產出、交給輝達就完成出貨認列。對台積電來說,「庫存」從生產到出貨只有製造週期本身(數週),而且下游早就排隊等著提貨——它收的是過路費,過路費沒有存貨跌價的問題。

算一下:兩邊的風險敞口可以用「從產品完成到收到錢的天數」來看:台達電=生產完成 → 運送 → 現場可安裝 → 驗收,期間可能以月甚至季計,且期間價格可能下修;台積電=出貨即收款(還有預付款在前面),敞口接近零。同一條供應鏈,庫存風險完全集中在其中一端。

工程重點 3:門口的隊伍就是定價權

貼文說「微軟慢一點,空出來的產能 Apple 馬上秒殺」——這不是誇張,先進製程的客戶名單就是配給制:產能按季分配、價格由台積電主導,客戶搶的是名額不是折扣。下游設備廠面對的卻是競標市場:延遲的專案會重新議價、重新招標。一個是賣方市場的極端,一個是買方市場的常態,這才是「一個被工期燙到、一個數錢數到手軟」的結構性原因。

AI 缺電怎麼救?SOFC 燃料電池 vs SMR 小型核能,終極能源大戰!台達電強勢參戰🔥
▶ AI 缺電怎麼救?SOFC 燃料電池 vs SMR 小型核能,終極能源大戰!台達電強勢參戰🔥

你覺得台達電的庫存壓力是暫時的時間差,還是資料中心建設週期性放緩的開始?

這題在粉專討論很熱,歡迎來留言 👉 PLC 粉專

資料來源:FB 原文貼文|vkinngworld・@vkinng

2026年11月1日 星期日

台達電SOFC+SST現場發電解析:AI資料中心為何改走直流供電?

台達電 SOFC 與 SST 直流供電架構

重點先講:AI 資料中心最缺的已經不是晶片,而是「什麼時候能通電」。這篇從粉專這則貼文(FB 原文)延伸,不重講 SOFC 原理,而是算三件事:供應鏈卡在哪、直流直連到底省多少、台達電的時程實際走到哪。

發生了什麼

  • 台達電在 2026 台灣國際智慧能源週展出 SOFC 現場發電方案與第一台實體 SST,並拿下大台北瓦斯 550kW SOFC 訂單。
  • SOFC 技術授權自英國 Ceres Power;台南二廠年底試產(約 5MW 規模),2027 年開始出貨,2028 年在桃園觀音擴大量產。
  • SST 方案把中壓交流直接轉成資料中心要的 800V 直流,台達電預估今年底出貨約 100 台,2028 年再大幅成長。

待核提醒:貼文寫的「100MW 產線」查不到;公開報導是台南約 5MW 試產、觀音 2028 量產。「SST 效率 92% 以上、體積小 50%」「2~3 家海外客戶實機驗證」目前也找不到台達電公開數字,本文一律視為貼文的示意數字。

工程重點 1:供應鏈瓶頸,卡的是「時間」

貼文提到電網排隊 3~7 年、燃氣渦輪機交期排到 2030、變壓器等 3 年。這些是業界普遍的說法(各地差很多),但重點很清楚:一座百 MW 級資料中心的 GPU 半年內就能到貨,電卻要等好幾年。台達電氫能部總經理蔡文蔭的說法是「買得到晶片,不見得買得到電」,所以美國客戶開始走 Bring Your Own Power:自己的電自己發。

SOFC 的優勢是模組化:一台一台疊,不用等一台大渦輪;而且沒有燃燒火焰,NOx 很低,空污許可相對好拿。

工程重點 2:直流直連的效率帳

傳統路徑:中壓 AC → 變壓器 → 低壓 AC → UPS 整流 → 逆變 → 機架 PSU → 晶片 DC,大約 5~6 段轉換。假設每段 98%,0.98⁶ ≈ 88.6%,等於每 100 度電有 11 度變廢熱。

SOFC 天生輸出直流,經 SiC 轉換器接到 800V DC 母線,再到機架 DC/DC,大約 2 段:0.98² ≈ 96%。以 100MW 負載估算,差 7 個百分點就是約 7MW,一年約 6,000 萬度電。這是簡化估算,實際要看各段真實效率。

工程重點 3:燃料端少燒四成

台達電公開的 SOFC 發電效率約 65%、熱回收後最高 85%;燃氣渦輪單循環約 35%。用 60% 對 36% 計算,同樣一度電的燃料用量是 0.36/0.60 = 0.6,大約 少燒 40%,跟貼文說法一致。複循環電廠能到 55~60%,但那是大型電廠,不是能放在園區內的規模。

工程重點 4:120kW 機櫃為什麼逼出 800V

機櫃從十幾 kW 跳到 120kW 以上,用 54V 匯流排電流會大到銅排吃不消。換成 800V,同樣功率電流降到約 1/15,銅損按 I² 下降。NVIDIA 也在推 800V HVDC 架構,Ceres 新一代電堆同樣主打「800V DC 相容」,SOFC+SST+800V 剛好接成一條線。

還缺什麼/待核

  • SOFC 量產規模:年底只是試產,真正放量要看 2028 觀音廠。
  • 電堆壽命與衰退率:資料中心要 24/7 運轉,換電堆的成本還沒有公開。
  • 天然氣價格與碳排:SOFC 仍然會排 CO₂,長期要靠氫氣或碳捕捉。
  • SST 的 92% 效率與體積小 50% 是貼文數字,等台達電公布規格再對。

相關影片

AI 缺電怎麼救?SOFC 燃料電池 vs SMR 小型核能,台達電強勢參戰
▶ AI 缺電怎麼救?SOFC 燃料電池 vs SMR 小型核能,台達電強勢參戰

SST 固態變壓器革命:為何 AI 大廠要淘汰傳統變壓器?
▶ SST 固態變壓器革命:為何 AI 大廠要淘汰傳統變壓器?

你覺得資料中心自己發電會變成標配,還是只是電網補上前的過渡方案?

工程師的量電小工具

【五金大王】FLUKE 101 KIT 數位萬用錶 (附磁性掛帶)

【五金大王】FLUKE 101 KIT 數位萬用錶 (附磁性掛帶)

TP-Link Tapo P110M Wi-Fi 迷你無線智慧插座 (支援 Matter / 電力監控)

TP-Link Tapo P110M Wi-Fi 迷你無線智慧插座 (支援 Matter / 電力監控)

本文含蝦皮分潤連結,透過連結購買我會獲得少量回饋,不影響你的價格。

這題在粉專討論很熱,歡迎來留言 👉 PLC 粉專

資料來源:Taipei Times 2026/10/15、DIGITIMES、工商時報、Ceres 2026 半年報|vkinngworld・@vkinng

2026年10月31日 星期六

台積電CoWoS-L 5.5倍光罩架構解析:4,720mm²封裝怎麼縫出來?


重點先講:
微影機一次能印的最大面積叫「光罩極限」,大約 26×33 mm=858 mm²。台積電 CoWoS-L 已經量產 5.5 倍光罩的封裝,等於在一個封裝裡塞進約 4,720 mm² 的矽與記憶體。粉專這篇(FB 原文)把它叫做「沒人做得到」,今天把它背後的工程拆開來看。

發生了什麼

  • 2026 北美技術論壇:台積電表示 5.5 倍光罩 CoWoS 已在生產,支援最多 12 顆 HBM3E/HBM4,良率 >98%。
  • 路線圖:原本最大是 2027 年 9.5 倍光罩(12 顆 HBM5、約 120×150 mm 基板);今年改口加碼,2028 年 14 倍光罩(約 10 顆大型運算晶粒+20 顆 HBM),2029 年超過 14 倍、最多 24 顆 HBM5E。
  • 系統級晶圓 SoW-X:40 倍光罩、最多 64 顆 HBM,量產時程從 2027 延到 2029。
算一下:858 mm² × 5.5 ≈ 4,719 mm²,跟圖上的 4,720 mm² 吻合。注意:這是「光罩當量」換算,台積電官方只講倍數,實際中介層尺寸與形狀以客戶設計為準。

工程重點 1:為什麼不能直接印一顆大晶片

光罩極限是光學硬上限,EUV 掃描機一次曝光就是 26×33 mm。晶片越大,一顆缺陷就廢掉整顆,良率隨面積指數下降。所以 AI 晶片改走 chiplet:把運算切成多顆接近光罩極限的 ASIC,再在封裝裡「拼」回來。問題變成:拼接處的頻寬要夠、延遲要低,這就是 CoWoS 的戰場。

工程重點 2:CoWoS-L 的「縫合」怎麼做

CoWoS-S 用一整片矽中介層,大到 3 倍光罩以上就要做光罩拼接(stitching),成本和破片風險暴增。CoWoS-L 改成 RDL 有機中介層+局部矽橋 LSI:只有晶粒之間、HBM 旁邊這些需要超細線距的地方埋一小塊矽橋,其他大面積走 RDL 重布線。好處是中介層能做大、又不必整片都用昂貴的矽;代價是矽橋對位、翹曲(warpage)控制都更難。

工程重點 3:做大以後,供電與散熱才是魔王

4,700 mm² 等級的封裝,功耗動輒上千瓦。電流要從基板穿過 RDL 送到每顆晶粒,壓降與電遷移都放大;熱則集中在運算晶粒,HBM 又怕熱。這也是為什麼台積電同時推 COUPE 共封裝光學、背面供電,以及業界開始談水冷板直接貼封裝——封裝越大,周邊工程一起升級。

工程重點 4:為什麼說是「封裝版摩爾定律」

從 3.3 倍 → 5.5 倍 → 9.5 倍 → 14 倍 → SoW-X 40 倍,台積電在用封裝面積換算力。Tom's Hardware 換算 14 倍光罩約 12,020 mm²,已經比 CD 還大一點。製程微縮越來越慢、越來越貴,把更多矽「縫」在一起,變成成長最快的那條曲線。

還缺什麼/待核

  • FB 圖標題寫「5 倍光罩」,實際官方規格是 5.5 倍;「沒人做得到」是貼文的說法,Intel EMIB、三星 I-Cube 也在做大封裝,只是量產規模目前台積電領先。
  • 4,720 mm² 是倍數換算的示意數字,非台積電公布的中介層實際面積。
  • 9.5 倍光罩是否仍照 2027 時程量產,今年新路線圖的重心已轉到 14 倍,需再看後續法說。

延伸影片

記憶體為什麼一直漲?HBM vs DDR 產能大戰

銅線撐不住了!硬核拆解矽光子與 CPO 終極封裝

你覺得封裝做到 14 倍、40 倍光罩以後,下一個瓶頸會是供電、散熱,還是 HBM 產能?

這題在粉專討論很熱,歡迎來留言:PLC 粉專

2026年10月30日 星期五

台積電 A16 晶背供電白話說明:為什麼要把晶圓翻面?5 步驟看懂超級電軌 SPR


重點先講:一般晶片是「往上蓋樓」,所有電線都從屋頂那一側拉進來。台積電 1.6 奈米級的 A16,則是把整片晶圓翻面,從背面把電灌進電晶體,還得把晶圓磨到比頭髮還薄。這篇不談艱深公式,用裝潢的比喻一步步帶你看懂。(這題我在粉專先用一張圖講過:看原始 FB 貼文)

先講結論:A16 到底改了什麼?

  • 電源線搬家:從晶片正面的金屬層,搬到晶圓背面,台積電叫它「超級電軌」(Super Power Rail,SPR)。
  • 正面空出來:M1~M10 這些金屬層全部還給訊號線,佈線更寬鬆。
  • 台積電公布(對比 N2P):同功耗快 8~10%,或同速度省電 15~20%,密度約 1.07~1.10 倍。

1. 不及格的水電師傅:老問題出在哪?

想像一間房子,總電源粗線和網路細線全塞在同一個天花板線槽。房子小的時候還行,但晶片過去幾十年一路縮小,到 2 奈米等級,導線細到比病毒還小。電線一細,電阻就上升,電在半路被吃掉一截,送到電晶體時電壓已經不夠,工程師叫它 IR drop(壓降);電源線也會發熱、干擾旁邊的訊號線。

📌 粉專圖上寫「白白燒掉 10~15% 電力」是幫助理解的說法,台積電沒有公布這個數字。業界設計時,通常會把壓降控制在供電電壓的一成左右當預算,意思相近,但不是「浪費掉的電」的實測值。

2. 天地分流:A16 的新裝潢

A16 的想法很像重新裝潢:天花板(正面)只走網路線,也就是訊號;地板暗管(背面)專門走粗電源線,再從底下垂直打洞,直接接到電晶體。台積電的特別之處在於背面電線是「直接接觸」電晶體的源極和汲極,不必繞路,這也是它比較難做的原因。

3. 五個步驟,看懂「把晶圓翻面」

步驟 ① 正面先蓋好一樓和天花板

跟平常一樣,在約 0.6~0.8 公釐厚的矽晶圓正面做出電晶體,再往上疊訊號金屬層。差別是這時不放主要的電源網路。

步驟 ② 黏上一片「載具晶圓」

等一下要把底座磨掉,晶圓會薄到撐不住,所以先把正面朝下,黏到另一片晶圓上當支架。

步驟 ③ 整片翻面

翻過來之後,原本的「底部」朝上,變成新的工作面。

步驟 ④ 磨到比頭髮還薄

用研磨加化學機械拋光(CMP),把原本幾百微米的矽底座幾乎全部去掉,只留電晶體附近極薄的一層。頭髮大約 50~100 微米粗,磨完的剩餘矽層遠比這薄得多。

步驟 ⑤ 在背面接電源

在背面開出極小的接點,對準上面的電晶體,再鍍上比較粗的電源金屬層,最後連到封裝。

4. 為什麼這麼難?

  • 對準:翻面後要從背面精準對到奈米級的電晶體,差一點就接錯。
  • 磨薄均勻度:整片 12 吋晶圓磨到極薄,厚度不均就會傷到電晶體。
  • 散熱:電晶體上下都被金屬層和接合材料包住,熱比較難散出去。
  • 成本與良率:多了接合、翻面、研磨和背面製程,步驟變多,每一步都會影響良率。

讀者常問 FAQ

Q:A16 是 1.6 奈米,所以電晶體縮小了嗎?
A:電晶體基礎沿用 N2P 的奈米片(GAA)架構,主要進步來自背面供電,「A16」是節點名稱,不是某個尺寸的實際長度。

Q:手機會用到嗎?
A:台積電把 A16 定位在 AI 和高效能運算(HPC),也就是線路複雜、耗電大的晶片。手機晶片短期主力還是 N2 系列。

Q:什麼時候量產?
A:說法有出入。台積電 2026 年 4 月技術論壇的路線圖寫 2027 年量產,但 VLSI 論文和 8 月台媒仍說 2026 年第四季,比較可能是「製程就緒」與「產品放量」的差別。

Q:Intel、三星也有嗎?
A:都有背面供電方案,Intel 叫 PowerVia。各家接法不同,台積電這種直接接觸的做法被認為最複雜。

還缺什麼/待核

  • 第一批量產產品與客戶,台積電尚未正式公布,坊間的客戶名單都是供應鏈傳聞。
  • 背面供電帶來的散熱代價有多大、要怎麼補救,目前公開數據有限。

延伸影片

背面供電解決的是晶片「內部」的電路問題,晶片做好後還要靠封裝把它們接在一起。想看下一步,可以看這支:

你覺得「翻面+磨薄」這五步裡,哪一步最可能卡住良率?歡迎留言。

這題在粉專討論很熱,歡迎來留言 👉 vkinng 粉專

想體驗一下日常版的「壓降」?手機充電時,電線越細越長,送到手機的電壓也會掉一點。用數顯充電頭配一條好線,就能直接看到功率差別:

【蝦皮直營】宏晉 65W 數顯氮化鎵快充頭 USB A + Type C 數字顯示

【蝦皮直營】宏晉 65W 數顯氮化鎵快充頭 USB A + Type C 數字顯示

台灣小米公司貨 小米 USB-C 傳輸線編織線版 100cm Type-C

台灣小米公司貨 小米 USB-C 傳輸線編織線版 100cm Type-C

本文含蝦皮分潤連結,透過連結購買我會獲得少量回饋,不影響你的價格。


資料來源:TSMC A16 技術說明(tsmc.com)、2026 VLSI Symposium T1.5、TrendForce 2026/04/23、Seoul Economic Daily 2026/08/21。整理:vkinngworld / @vkinng。

台積電 SPR vs 台達電 VPD 比較:晶片級與機板級背面供電差在哪?1000A I²R 損耗計算


晶片級 vs 機板級:兩個「背面供電」

重點先講:「背面供電」這四個字最近同時出現在台積電和台達電的新聞裡,很多人以為是同一件事。其實一個在晶片內部(奈米級),一個在主機板上(毫米級)。這篇接著我粉專這則貼文 〈台積電SPR,台達電VPD都是背面供電,有何差異?〉,用工程數字算給你看:為什麼 AI 晶片吃到 1000A 時,兩個背面都少不了。


圖:晶粒級 SPR(左)與系統級 VPD(右)的供電路徑對照(@vkinng 粉專原圖)

發生了什麼

  • 台積電 A16 / SPR:官方數據為相較 N2P,同電壓速度快 8–10%、同速度功耗降 15–20%、密度最多 1.10 倍。電源軌移到晶背,直接接到電晶體的 source/drain。
  • 台達電 VPD:台達在 GTC 與 Computex 展示垂直供電模組,把 48V→0.8V 的 DC-DC 轉換放到 AI 晶片背面,官方說法是可減少 AI 加速器系統 5–15% 的能源損耗;2025/8 與英飛凌合作,採 OptiMOS 90A 功率級開發 VPD 模組。
  • 兩者共同的邏輯:把電改走垂直的最短路徑,讓電流少走一段電阻。

一句話分工:SPR 解決「晶片裡最後一微米」,VPD 解決「機板上最後十公分」。前者是晶圓廠的製程,後者是電源廠和主機板、封裝設計的事。

工程重點 1:1000A 下的 I²R,為什麼每 0.1mΩ 都很貴

功率損耗 P = I²R。手機晶片吃幾安培,0.1mΩ 根本無感;但 AI GPU 核心電壓不到 1V、電流超過 1000A(英飛凌公開提到頂級 AI 晶片已達 2000A 以上)。代入算:

  • 1000A × 0.1mΩ = 100mV 壓降,對 0.8V 核心等於 12.5% 的電壓預算直接沒了。
  • (1000A)² × 0.1mΩ = 100W 熱,而且是發生在電路板上、還要另外散掉。
  • 電流變 2 倍,損耗變 4 倍。這就是為什麼電流越大,越要把路徑砍短。

工程重點 2:主機板銅層的橫向電阻怎麼算

PCB 電源平面用「方塊電阻」估算:1oz 銅(約 35μm)大約 0.5mΩ/□。假設伺服器板用 10 層電源/地平面並聯,降到約 0.05mΩ/□。如果 VRM 放在板邊,電流要橫走 10cm、有效寬度 5cm,就是 2 個方塊 ≈ 0.1mΩ,剛好回到上面那個 100W 的例子(再加上去程與回程、過孔、接頭會更多)。

垂直供電把模組放到 GPU 正下方,電流只要穿過約 1–2mm 的板厚,靠大量並聯過孔上去,路徑電阻可以降一個數量級以上。粉專貼文裡的「220mV→5mV、18W→1.2W(省約 93%)」是用來說明量級的示意數字,台達官方公開的是「省 5–15% 系統損耗」與「TVR 效率 >94%」。

工程重點 3:VRM 位置演進,從板邊到正下方,再到封裝裡

  • 第一代:橫向(Lateral)— VRM 圍在 CPU/GPU 四周,電流沿 PCB 平面流進來,最直觀也最好散熱。
  • 第二代:垂直(Vertical)— 模組放在處理器背面,取代原本那裡的去耦電容;因為離負載近,暫態響應更快,電容電感需求也降低。
  • 第三代:封裝內 / 晶片內(IVR)— 把最後一級穩壓做進封裝甚至晶粒,像 Intel 早年的 FIVR。電流在更高電壓下走到很近才降壓,但會把熱和面積塞回晶片附近。
  • 而台積電 SPR 就是再往裡一層:電已經到了晶粒,最後從金屬層走到電晶體的那一小段也改走背面。

工程重點 4:兩層「背面」怎麼疊加,以及代價

把整條供電鏈想成串聯電阻:48V 匯流排 → 板上降壓 → 板上銅層 → 封裝載板 → 晶粒內金屬層 → 電晶體。VPD 砍的是「板上銅層」那段,SPR 砍的是「晶粒內金屬層」那段,兩者不重疊,所以效益可以相加。

  • 空間紅利:GPU 四周不再被電感、MOSFET 包圍,可以讓給 HBM 堆疊與高速 SerDes 走線;晶粒正面的金屬層也全部還給訊號。
  • 散熱取捨:VPD 等於把一個 1000W 等級轉換器的損耗熱(效率 94% 時仍有數十瓦)放到 GPU 背後,正面有冷板,背面也得處理;SPR 則因晶圓薄化、背面多了金屬,晶片內熱點與散熱路徑都要重新設計。
  • 維修與良率:模組在 GPU 底下不易重工;SPR 則多了晶圓接合與薄化製程,成本與良率是代價。

還缺什麼/待核

  • A16 量產時程各來源說法不一(2026 下半年到 2027),首發客戶仍屬供應鏈說法。
  • 晶圓薄化到「約 3.5μm」與「220mV→5mV、18W→1.2W」屬貼文示意數字,查無台積電或台達電官方公開來源。
  • 台達 VPD 實際導入哪一代 GPU 平台、量產規模,目前沒有官方公布。

延伸影片

AI 資料中心的供電,從電網一路到晶片都在升級,這兩支影片講的是前半段:

你覺得下一步會是什麼:VRM 直接做進封裝,還是乾脆把電壓拉更高送到晶片旁邊?這題在粉專討論很熱,歡迎來留言聊聊 🙌

自己動手量「壓降」:工程師小工具

想親手感受 I²R?拿電表量一條電源線兩端的電壓差,或用電力監控插座看設備待機與滿載的瓦數,就是最便宜的 PDN 入門實驗。

數字萬用表 DT9205A 高精度電子數顯萬能表

數字萬用表 DT9205A 高精度電子數顯萬能表

TP-Link Tapo P110M Wi-Fi 迷你無線智慧插座 (支援 Matter / 電力監控)

TP-Link Tapo P110M Wi-Fi 迷你無線智慧插座 (支援 Matter / 電力監控)

本文含蝦皮分潤連結,透過連結購買我會獲得少量回饋,不影響你的價格。

來源:TSMC A16 技術說明;Delta 2024 GTC/Computex 2024 新聞稿;Infineon × Delta 2025/8/28 新聞稿;APEC 2025 TVR 論文摘要。文:vkinngworld | YouTube @vkinng

2026年10月29日 星期四

台積電 A16 背面供電原理:SPR 超級電軌如何解決 IR Drop?與 Intel PowerVia 比較


重點先講:過去五十年,晶片的電源線和訊號線一直住在同一面,像一棟大樓把水管和電線全塞進同一條天花板線槽。製程縮到 2 奈米以下,這條線槽已經擠到影響效能。台積電 A16 的解法很直接:把整張供電網搬到晶圓背面,正面只跑訊號。這篇用工程角度拆開看:IR Drop 到底吃掉什麼、為什麼一定要翻到背面、SPR 跟 Intel PowerVia 差在哪,以及晶圓翻面之後冒出來的散熱和測試難題。

發生了什麼

  • 官方規格:A16 = 奈米片電晶體 + Super Power Rail。對比 N2P,同 Vdd 速度 +8~10%、同速度功耗 −15~20%、晶片密度最高 1.10 倍(台積電的「晶片密度」是邏輯、SRAM、類比混合計算,Tom's Hardware 整理為 1.07~1.10 倍)。
  • 時程:原訂 2026 下半年量產;2026 年 4 月北美技術論壇,台積電資深副總暨副共同營運長張曉強說 A16「2026 年就緒,但放量看客戶產品週期」,路線圖改列 2027 年。媒體報導量產落在高雄 F22 的 P4 廠。
  • 誰會用:10/15 法說會上,法人問電力吃緊會不會讓更多客戶採用背面供電,魏哲家說看產品需求:部分 AI 加速器可能用,手機不會。外電報導 NVIDIA 的 Feynman GPU(約 2028 年)是首批客戶,但雙方都沒有正式證實。
  • 對手:Intel 18A 的 PowerVia 已隨 Panther Lake 量產,背面供電是 Intel 先做出來的;三星規劃 2027 年在 SF2Z 導入。


圖:我在粉專做的〈傳統正面供電 vs 台積電 A16 背面供電〉圖解,原文在 這篇粉專貼文。這篇部落格把圖上沒空間講的物理和製程細節補完。

一句話看懂:正面供電=電從屋頂進來、一路穿過十幾層樓梯才到地下室的機器;背面供電=直接從地下室旁邊開一扇門把電送進去。路變短、管線變粗,壓降就變小,正面也空出來給訊號走。

工程重點 1:IR Drop 吃掉的不只是電,是電壓裕度

IR Drop 就是歐姆定律 V = I × R。AI 加速器核心電壓不到 1 V,功耗卻上千瓦,等於供電網要扛 上千安培。在 1000 A 下,供電路徑每多 0.05 mΩ 電阻,就多掉 50 mV,已經是 0.75 V 核心電壓的 6~7%。正面供電的電流要從頂層凸塊往下穿過十幾層金屬和一串通孔,最底下的 M0/M1 線寬只剩十幾奈米,銅在這種尺寸下電阻率還會因為表面散射往上升,越靠近電晶體的那幾段反而越細、越貴。

真正的代價在後面:設計時必須保證最遠、最忙的電晶體也拿得到足夠電壓,所以整顆晶片的供電電壓要往上墊。動態功耗跟電壓平方成正比(P ∝ C·V²·f),電壓多墊 5%,動態功耗就多約 10%。業界常見把 IR Drop 預算抓在 VDD 的 10% 左右(imec 的 A14 研究就是用這個目標)。背面供電能把這筆裕度收回來,這就是「同速度省電 15~20%」很大一部分的來源。

工程重點 2:SPR、PowerVia、埋入式電軌,三種背面供電差在「接到哪」

  • 埋入式電軌(Buried Power Rail, BPR):imec 早期提的路線,把電源軌埋到電晶體下方的基板裡,先解決標準單元裡電源軌佔空間的問題。電軌本身仍要靠正面或奈米級矽穿孔(nTSV)餵電,算是過渡方案。
  • Intel PowerVia:從背面打奈米級 TSV,接到單元的接觸層(contact)。結構相對單純、成本較低。Intel 在 Intel 4 測試晶片上公布:平台電壓下降改善超過 30%、頻率 +6%、標準單元利用率超過 90%;18A 官網則寫最差動態壓降最多降 10 倍、區塊面積最多縮 11%。
  • 台積電 SPR:背面接觸直接連到電晶體的源極/汲極,不必在單元裡留穿孔的位置。台積電說這樣能「維持閘極密度和元件寬度的設計彈性」。代價是製程最複雜、最貴,這也是為什麼台積電同時保留不帶 SPR 的 N2P/N2X 給不需要的客戶。

簡單說,PowerVia 是「從背面接到單元門口」,SPR 是「從背面直接接到電晶體本體」。路徑越短,電阻越低,正面空出來的繞線資源也越多,密度那 1.07~1.10 倍主要就是從這裡來。

工程重點 3:晶圓要「翻面、磨薄、對準」,每一步都是良率關卡

背面供電的通用流程大致是:先在正面做完電晶體和整套訊號金屬層 → 把正面鍵合到一片承載晶圓(carrier wafer)上 → 整片翻過來 → 把原本幾百微米厚的矽基板研磨、CMP、蝕刻到只剩極薄一層 → 在背面做接觸、通孔和背面金屬層(粉專圖上標的 BM0/BM1)→ 最後在背面長凸塊接封裝。

難點有三個:磨薄均勻度要控制到奈米等級,磨過頭會傷到電晶體;鍵合造成的晶圓變形會讓背面微影跟正面電晶體對不準,而 SPR 要直接打到源極/汲極,對準容錯比 PowerVia 更小;多出來的鍵合、薄化、背面金屬化步驟也拉長製程、推高成本。IDC 分析師就估,A16 真正的產能貢獻要等良率爬完,落在 2027 下半年到 2028 年。

工程重點 4:散熱路徑改變、除錯工具失明

傳統覆晶封裝的熱,是從電晶體穿過厚矽基板直接傳到散熱蓋。背面供電之後,電晶體被夾在中間:一邊是背面金屬和凸塊,另一邊是正面那十幾層以介電質為主的訊號層再加承載晶圓,而介電質導熱很差。熱點溫度怎麼壓、承載晶圓和鍵合層要不要用導熱更好的材料,是背面供電共同的課題。Intel 公布 PowerVia 時也特別提到,散熱和除錯是兩大新挑戰,需要另外開發緩解手法。

除錯也一樣:失效分析常用的雷射電壓探測、光子發射顯微鏡,本來是從晶片背面「透過矽」去看電晶體。現在背面被金屬供電網蓋住,這招行不通,量測和失效分析流程都要重做。對 AI 加速器這種動輒數百平方毫米的大晶片,這直接影響良率學習速度。

還缺什麼/待核

  • 圖解裡「正面供電白白燒掉 10~15% 電力」是概念性說法,台積電沒有公布這個數字。比較有根據的說法是:IR Drop 設計預算常抓在 VDD 的 10% 左右,實際損失看設計和負載而定。
  • 8~10% 和 15~20% 是台積電對 N2P 的「目標值」,二者擇一(同電壓拿速度,或同速度拿省電),不會同時拿滿;目前還沒有第三方實測的 A16 產品。
  • NVIDIA Feynman 採用 A16 來自供應鏈報導,官方未證實;A16 晶圓價格、良率也都沒公開。

延伸影片

背面供電解決的是「一顆晶片裡面」的供電;當晶片開始往上疊,供電和散熱的問題會再放大一層。這兩支剛好可以接著看:


想問你:背面供電讓晶片更快更省,但製程更貴、散熱更難。你覺得它會一直是 AI 晶片的專屬配備,還是幾年後連手機晶片也會跟進?

這題在粉專討論很熱,歡迎來留言 👉 vkinng 粉絲專頁

手邊就能看到的 IR Drop:晶片裡的壓降要用模擬才看得到,但同一個 V = I × R 在你的充電線上也會發生。用 USB 電表或萬用表量量看,大電流時線尾電壓掉多少,就是最直觀的 IR Drop。

FNIRSI FNB-C2 USB PD 3.1 Type-C 快充測試儀 電壓電流表

FNIRSI FNB-C2 USB PD 3.1 Type-C 快充測試儀 電壓電流表

美國 FLUKE 101 F101 掌上型數位萬用表

美國 FLUKE 101 F101 掌上型數位萬用表

本文含蝦皮分潤連結,透過連結購買我會獲得少量回饋,不影響你的價格。

2026年10月28日 星期三

GaN 雙向開關原理:Enphase 固態變壓器 13.8kV 直轉 800V,為何不用 SiC?


重點先講:這週有兩則新聞要放在一起看。10/26 Infineon 宣布要供應全球首款 900 V GaN 單晶雙向開關(Bidirectional Switch, BDS)給 Enphase;10/27 Enphase 就公布它的固態變壓器(IQ SST)完成 13.8 kV 交流直轉 800 V 直流的展示。大家印象中,中壓電力電子是碳化矽(SiC)的地盤,這次卻是 GaN 用「串聯拆電壓+雙向開關」的打法闖進來。

發生了什麼

  • Infineon(10/26):CoolGaN 900 V 單晶雙向開關已完成測試,正整合進 Enphase IQ SST 產品開發,量產驗證(production qualification)還在後面。兩家之前已在 Enphase IQ9 微型逆變器上合作 650 V GaN BDS。
  • Enphase(10/27):Austin 實驗室展示 132 個功率模組、每相 44 個串聯,13.8 kV AC 轉 800 VDC,負載階躍(模擬 AI 機櫃負載急變)下輸出穩定;官方說每個模組只承受「幾百伏」。
  • 每個模組額定 5.5 kW,內含 GaN 開關、第五代 Kestrel ASIC(22 nm)和自製高頻變壓器;官網寫高頻運作 >250 kHz、峰值效率 >98.5%。
  • 下一步:「未來幾週」挑戰 34.5 kV;2026 年底前展示 MW 級完整機櫃,2027 客戶試點,2028 量產出貨(4 月公告的時程)。

一句話看懂:傳統做法是「60 Hz 大變壓器降壓 → 整流 → 再 DC/DC」多級串起來;SST 是把中壓交流切碎給一堆小模組,每個模組用高頻變壓器隔離後直接輸出直流。開關元件不必耐 13.8 kV,只要耐住自己分到的那幾百伏。

工程重點 1:13.8 kV 分給 44 個模組,每個只剩約 250 V

13.8 kV 是線電壓有效值。假設三相各一串、接成星形(Y),相電壓 = 13.8 ÷ √3 ≈ 7.97 kV rms,峰值 ≈ 7.97 × √2 ≈ 11.3 kV。除以 44 個串聯模組,每個大約 256 V 峰值。就算改成三角形(Δ)接法,每串吃線電壓峰值 19.5 kV,平均也只有約 444 V。兩種算法都落在 Enphase 說的「幾百伏」。

再對照 4 月公告的 1.25 MW 機櫃:342 個模組 ÷ 3 相 = 114 個/相。若對應 34.5 kV 等級,相電壓峰值 ≈ 34.5 ÷ √3 × √2 ≈ 28.2 kV,÷114 ≈ 247 V。兩組數字幾乎一樣,說明 Enphase 的設計邏輯是「每個模組固定吃約 250 V,電壓等級越高就串越多個」。(接法與對應關係是作者推估,官方未公開拓樸細節。)

工程重點 2:為什麼一定要「雙向」開關?

一般 MOSFET 或 GaN HEMT 只能單方向擋電壓,反方向有體二極體(或等效通道)會導通。交流電正負半週輪流來,想讓交流不先整流就直接送進高頻變壓器(單級轉換),開關就必須兩個方向都擋得住、也都能導通。傳統解法是兩顆開關背對背(back-to-back)串起來。

背對背的代價很直接:兩顆串聯,導通電阻相加。理想化估算,要讓總電阻等於一顆單向開關的 R,每顆得做到 R/2,晶片面積各變 2 倍,總面積約 4 倍。Infineon 的單晶 BDS 是「共汲極、雙閘極」結構,兩個方向共用同一段漂移區(drift region)來擋電壓,高壓元件裡最大宗的漂移區電阻只算一次,所以晶片小很多(官方只說 die size 較小,沒給倍數;4 倍是作者的理想化推算)。它還有四種模式:雙向導通、雙向阻斷,以及兩種「可控二極體」模式,專門配合軟切換。

工程重點 3:從 650 V 拉到 900 V,多出來的 250 V 用在哪?

Infineon 新聞稿點名一個應用:美國 480 V 三相商用太陽能逆變器,可以做「線對線」設計。算一下就懂:480 V 線電壓峰值 = 480 × √2 ≈ 679 V,已經超過 650 V,還沒算切換時的電壓過衝。900 V 才有足夠餘裕直接跨在線電壓上,開關數量跟轉換級數都能減少。

放回 SST,Enphase CTO 的說法是「更多電壓餘裕,同時保留高頻切換的好處,可以拿掉轉換級」。在 SiC 擅長的 1200 V 以上,GaN 還不是對手;但在「每個模組幾百伏、切得越快磁性元件越小」的分散式架構裡,900 V GaN 剛好卡進甜蜜點。

工程重點 4:高頻變壓器與發熱帳

變壓器要承受的伏秒(V·s)跟頻率成反比。從 60 Hz 拉到 250 kHz 以上,頻率差約 4,000 倍,理論上磁芯截面可以縮小非常多;實際上會被磁芯損耗、繞線的集膚效應和絕緣距離卡住,不會真的縮 4,000 倍,但已經足以把變壓器塞進一個 5.5 kW 的模組裡。

效率方面,以 1.25 MW 機櫃、98.5% 計算,損耗約 1.25 MW × 1.5% ≈ 18.8 kW 的熱,要靠機櫃散熱帶走(98.5% 是官方「峰值」效率,滿載實際值未公布)。另外有個有趣的數字:342 個 × 5.5 kW ≈ 1.88 MW,比機櫃額定 1.25 MW 多約 50%。4 月投資人簡報寫的是每模組 4 kVA(342 × 4 ≈ 1.37 MW),所以可能是模組規格升級後保留了冗餘餘裕,好讓壞掉幾個模組仍能滿載運轉(作者推估)。

還缺什麼/待核

  • 900 V BDS 的導通電阻、封裝、datasheet 都還沒公開;量產驗證尚未完成。
  • Enphase 新聞稿沒說 13.8 kV 展示的模組是否已用 900 V BDS,也沒公布展示時實際跑到多少功率(132 × 5.5 kW = 726 kW 只是額定加總,不是實測值)。
  • 中壓配電的雷擊突波(BIL)與故障電流遠高於工作電壓,一整串半導體模組怎麼扛?高頻變壓器對地的絕緣與局部放電怎麼處理?官方尚未說明。
  • GaN BDS 沒有本體二極體,白皮書明講要避免無箝位電感切換;模組故障時的保護與旁路機制細節未公開。
  • 34.5 kV 展示與 MW 級完整機櫃都還是「預計」。

相關影片(@vkinng)

SST 固態變壓器革命 影片縮圖

你怎麼看?中壓 SST 最後會是「SiC 少量高壓模組」還是「GaN 大量低壓模組串聯」勝出?一串上百個模組,你最擔心的是可靠度、突波保護,還是維修?留言聊聊。

想摸摸看 GaN 實物?桌上的氮化鎵充電頭就是同一家族的元件(單向 650 V GaN),體積能做這麼小,靠的也是「切得快、變壓器小」:

寶利威爾 POLYWELL 65W 三孔 PD 快充頭 雙 USB-C + USB-A GaN 充電器

寶利威爾 POLYWELL 65W 三孔 PD 快充頭 雙 USB-C + USB-A GaN 充電器

Gigastone 65W GaN 氮化鎵三孔快充充電器 PD-7653B

Gigastone 65W GaN 氮化鎵三孔快充充電器 PD-7653B

本文含蝦皮分潤連結,透過連結購買我會獲得少量回饋,不影響你的價格。

AI 伺服器到底多耗電、為什麼電力架構非改不可?我在 FB 粉專也聊過:AI 伺服器為什麼這麼耗電?(更多內容在 PLC 粉專)

2026年10月27日 星期二

LMR 富錳電池原理:GM 第四代電動車為何捨 LFP?電壓衰減與 33% 能量密度解析


重點先講:電池界一直有個兩難:要便宜選 LFP 磷酸鐵鋰,要跑得遠選 三元鋰(NMC/NCA)。GM 10/21 在 GM Forward 發表會端出第三條路:第四代電動車平台將用 LMR 富錳電池(lithium manganese rich),號稱全球第一款量產 LMR。下面拆四件事:配方換了什麼、電壓衰減為什麼是死穴、20% 效率對電池容量的意義,以及方形電芯帶來的結構帳。文中的車款耗電、容量與重量換算是我自己的假設與示意算術,不是 GM 數據。

發生了什麼:GM 第四代平台與 LMR 電池

  • 10/21 GM Forward(紐約):第四代平台結合 LMR 方形電芯、新驅動單元與中央運算架構;GM 說每 kWh 能多跑約 20% 里程。電芯由 GM 與 LG Energy Solution 合資的 Ultium Cells 在田納西 Spring Hill 生產。
  • 官方數字:LMR 能量密度比 LFP 高 33%、成本相當;驅動單元零件數少 40%;線束少 30%;開發時用電腦模擬超過 30 萬種電池設計,從第一個電池包概念到正式立案只花一個月。
  • Car and Driver 補充:GM 主管 Zach Walker 說第四代車重約輕 15%、風阻係數低 25%、新驅動單元效率高 20%,合起來約可少用 20% 電池容量。GM 沒有公布電池包 kWh、每 kWh 成本、首發車款與上市日期。

一句話看懂 LMR:它是層狀氧化物正極(跟三元鋰同家族),但在晶格裡多塞了鋰、用大量錳取代鎳和鈷。多出來的鋰讓容量變高,錳讓材料變便宜;代價是第一次充到高電壓時晶格會「重組」,之後電壓慢慢往下掉。

工程重點 1:LMR 配方,用錳換掉鎳和鈷

GM 自己給的對照很直白:典型高鎳電芯大約是 鎳 85%、錳 10%、鈷 5%;LMR 大約是 鎳 35%、錳 65%、鈷幾乎為零(TechCrunch、WIRED 引述的範圍是錳 60–70%、鎳 30–40%、鈷 0–2%)。錳比鎳、鈷便宜也好取得,這是 LMR 能喊出「LFP 的價格」的底氣。能量密度方面,GM 說比 LFP 高 33%,Car and Driver 的說法是接近現在的 NMCA。換句話說,LMR 想站在 LFP 跟三元鋰中間,吃兩邊的好處。GM 沒說這 33% 是重量能量密度還是體積能量密度,這點後面算帳時要小心。

工程重點 2:電壓衰減,富錳正極卡關十幾年的死穴

LMR 的高容量來自晶格裡的 Li₂MnO₃ 成分。美國能源部的「Deep Dive」研究整理過:第一次充電時,約 4 V 先從一般層狀區拔出鋰,到了約 4.45 V 以上 Li₂MnO₃ 區才被「活化」,靠氧參與氧化還原多吐出鋰;Argonne 的同步輻射實驗在約 4.46 V 觀察到晶格應變與氧釋放。問題是活化後晶格不穩,錳離子會遷移到鋰層,局部結構慢慢變成能量較低的排列,於是每圈放電電壓都往下掉一點,這就是電壓衰減。2017 年的模擬研究甚至寫,衰減要壓到約 0.1 mV/圈 這個等級才適合車用,並建議把上限電壓限制在約 4.6 V 以下。GM 說已和供應商用專有摻雜、表面塗層、顆粒工程與製程改良解決,壽命可比照現行高鎳電芯,但目前沒有公開的循環曲線可以核對。

工程重點 3:每 kWh 多跑 20%,電池能少多少?

「多跑 20%」跟「少用 20% 電池」不完全是同一件事。同樣里程下,需要的電量是 1 ÷ 1.2 ≈ 0.83,也就是少約 17%;Car and Driver 引述的「約 20%」是取整後的說法。舉例(作者假設):一台中型休旅要跑 300 英里,假設現在每 kWh 跑 3.3 英里,需要約 91 kWh;效率提升 20% 後只要約 76 kWh。再疊上 LMR 比 LFP 高 33% 的能量密度(假設是重量密度),同電量的電芯重量是 1 ÷ 1.33 ≈ 0.75;兩者相乘約 0.63,代表電芯重量可能比「同里程、用 LFP、舊效率」的設計少三成多。這是示意算術,沒算電池包結構、冷卻和安全餘裕。

工程重點 4:方形電芯,把模組和零件砍掉

現行 Ultium 用的是軟包(pouch)電芯,LMR 改成方形(prismatic)硬殼。GM 2025 年的說明是:方形電芯讓模組零件減少 75%、整包零件減少 50%,非活性材料比例也跟著下降。硬殼本身能承受一部分結構與膨脹應力,電池包就不必再用那麼多支架和緩衝件。BMS 也有新功課:層狀氧化物的放電曲線本來就比 LFP 傾斜,用電壓估電量比 LFP 容易;但如果電壓會隨老化往下飄,電量估算的對照表就得跟著修正,否則儀表上的剩餘里程會越用越不準(這段是我的工程推論)。

還缺什麼/待核

  • GM 沒公布電池包 kWh、每 kWh 成本、循環壽命曲線,也沒有第三方的電壓衰減測試。
  • 首發車款說法不一:Car and Driver 說先上全尺寸電動皮卡,InsideEVs 引述發言人說是跨界休旅,Bloomberg 說約三年內推出主流電動休旅。
  • 33% 是重量還是體積能量密度未說明;本文 3.3 英里/kWh、300 英里與 0.63 倍重量都是作者假設。

相關影片:三元鋰、LFP 與電池成本

三元鋰與磷酸鐵鋰電池差異影片縮圖:LMR 富錳電池的比較基準

如果 2028 年真的有一台用 LMR、價格跟 LFP 車差不多、但多跑兩三成的電動車,你會買嗎?還是在看到十萬公里的電壓衰減數據之前,你寧可先選成熟的 LFP?留言聊聊。

更多電池材料與製程的白話拆解(例如乾式電極),可以到我的 FB 粉專「PLC」看看:乾式電極到底神在哪?用「做千層酥皮」看懂電池製程革命(粉專首頁)。

手邊就能觀察的鋰電池:行動電源與 USB 電表

LMR 的關鍵字是「電壓」。想親手看看鋰電池的電壓、電流怎麼隨電量變化,一顆行動電源加一個 USB 電表就能玩:

【行動電源 1】Anker A1664 MagGo 10000mAh Qi2 30W 超薄磁吸行動電源 (授權直營)

【行動電源 1】Anker A1664 MagGo 10000mAh Qi2 30W 超薄磁吸行動電源 (授權直營)

【USB電表 1】FNIRSI FNB-C2 USB PD 3.1 Type-C 快充測試儀 電壓電流表

【USB電表 1】FNIRSI FNB-C2 USB PD 3.1 Type-C 快充測試儀 電壓電流表

本文含蝦皮分潤連結,透過連結購買我會獲得少量回饋,不影響你的價格。