
重點先講:我們在 SST 影片裡講過「寧願掉一點效率,也要換來保護能力」。上週 OCP 全球峰會(10/12–15)期間,800V 直流機櫃的焦點從「怎麼把電送進去」轉到「出事時怎麼把電切掉」。下面拆四件事:直流為什麼難斷、微秒和毫秒差多少、固態斷路器的導通損耗帳,以及它還不能完全取代機械開關的原因。廠商資訊來自新聞稿與訪談,電流與損耗數字是我的算術示意,不是實測。
發生了什麼
- 10/12 Power Integrations × Ideal Power:合作開發 800 VDC 固態斷路器,用 1700V GaN 的 InnoMux-2 直接從 800V 母線取電、供給閘極驅動與感測電路,主開關是 Ideal Power 的雙向 B-TRAN。已有可運作原型,參考設計開發中。
- 10/12 Infineon XDP8HD40S-1:給 ±400V/800V AI 伺服器的數位熱插拔控制器,內建數位 SOA(安全工作區)控制、可驅動 SiC MOSFET+JFET 疊接開關、PMBus 遙測與故障黑盒子紀錄,樣品排在 2027 年第二季。
- NVIDIA 800 VDC 白皮書第二版:第一批量產系統以塑殼斷路器(MCCB)為主,清除時間最長可能約 20 ms;SSCB 先鎖定 125A 氣冷與 1250A(可能要液冷)兩種規格。
為什麼直流比較難斷?交流電 60 Hz 每 8.3 毫秒(50 Hz 是 10 毫秒)電流就會自然經過一次零點,機械開關只要在零點附近把觸點拉開,電弧就容易熄滅。直流沒有過零點,電弧可以一直燒下去,機械斷路器得靠滅弧室把電弧電壓撐到比系統電壓還高,才能硬把電流壓下來,所以又慢又傷觸點。
工程重點 1:短線路+高電壓=電流瞬間暴衝
AI 機櫃為了省銅、少損耗,電纜盡量短,線路電感很小。短路電流的上升速度大約是 di/dt ≈ V/L。假設迴路電感 1 µH、電阻 5 mΩ(示意值),800V 短路時電流每微秒爬升約 800 A:5 µs 時約 4 kA,若放任 1 毫秒,理論上會衝到接近 160 kA。Infineon 系統架構師 Bernacchia 的說法一樣直白:客戶要求微秒級反應,因為等到毫秒級,電流會到數十萬安培等級,「然後所有東西都毀了」。實際系統會靠電源端的限流與快速關斷壓低故障電流,這也是 NVIDIA 白皮書要求 SST 與整流器具備快速關斷的原因。
工程重點 2:固態斷路器永遠「在路上」,導通損耗要算
機械斷路器的金屬觸點平常幾乎不吃電,固態斷路器則是半導體一直串在主電路上,損耗是 I²R。以 NVIDIA 鎖定的規格算:125A、800V 約 100 kW,開關導通電阻 2 mΩ 時損耗約 31 W,佔 0.03%,還好;到 1250A(約 1 MW),就算只有 1 mΩ 也是 1.56 kW 的熱,集中在一個小盒子裡,這就是 1250A 版本「可能要液冷」的原因。想把損耗壓到 0.05%(500 W),導通電阻得低到約 0.32 mΩ。麻煩的是,Infineon 指出降低導通電阻(晶胞排更密)和提高短路耐受的 SOA 互相矛盾,所以他們選 SiC JFET;Ideal Power 則主打 B-TRAN 的低導通損耗。另一個細節是控制電路的電要從哪來:PI 的做法是直接從被保護的 800V 母線降壓自供電,省掉外部輔助電源。
工程重點 3:快要快,但不能誤跳
GPU 進入訓練時,電流會在極短時間內衝到額定的好幾倍。保護器如果把這當成短路,整個系統就被自己關掉。Infineon 的數位控制器用突波計時器與濾波:短暫的尖峰放行,過電流持續超過預設時間才跳脫。再加上 EMI 濾波器(電感+電容)在負載突變時會振盪,過電流門檻設不好就會誤跳。
工程重點 4:半導體壞掉是「短路」,所以還需要機械氣隙
固態開關反應快、沒有觸點磨耗,但目前功率元件的典型失效模式是短路導通,元件壞了等於沒隔離。所以涉及人員安全的地方,標準仍要求機械繼電器提供物理氣隙與電氣隔離。規模放大後還有並聯問題:1 MW 機櫃需要數十顆元件並聯,關斷時間只要差幾百奈秒,電流就可能集中到某一顆上把它燒掉。NVIDIA 的近期解法是混搭:MCCB 先上、搭配饋線備援或保持時間撐過 20 ms,接頭用機械互鎖(插好鎖定才送電、拔之前先斷電),長期再轉向 SSCB。我的推論是:2026–2027 年 SSCB 會先出現在機櫃內的電源架,配電層級的 1250A 版本要等認證與成本到位。
還缺什麼/待核
- PI × Ideal Power 只說原型可運作,尚未公布導通損耗、關斷時間、額定電流等數字。
- Infineon XDP8HD40S-1 是控制器,不是完整斷路器,樣品 2027 Q2;完整 SSCB 仍由客戶或合作方(如 SolarEdge)設計。
- SSCB 在 IEC/UL 等安全標準下的認證路徑,以及資料中心是否能放寬機械氣隙要求,仍在討論中。
- 文中 1 µH/5 mΩ 的短路電流與 2 mΩ、1 mΩ 的損耗是示意換算,實際依線路、接地方式與電源限流而不同。
相關影片
- SST 固態變壓器神級護盾解析,寧願掉效率也要換!看懂「轉換效率 vs 功率因數」的世紀迷思
- SST 固態變壓器革命:為何 AI 大廠寧願犧牲 99% 效率也要淘汰傳統變壓器?
- 電動車 400V 升 800V 的秘密:碳化矽 (SiC) 才是最強心臟!
今天想問你:如果你在設計 800V 機櫃,你會先用成熟的機械斷路器加備援,還是直接上固態斷路器、多付一點損耗換微秒級保護?留言告訴我你的理由。
想自己動手量電流、看用電?家裡的電當然不是 800V 直流,但「先量得到,才保護得了」的道理一樣。這兩樣是我覺得入門好用的工具:
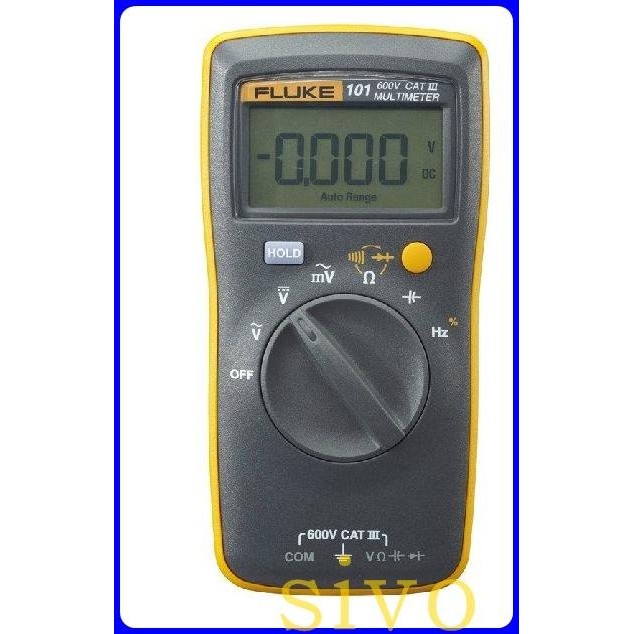
【萬用電表 1】美國 FLUKE 101 F101 掌上型數位萬用表
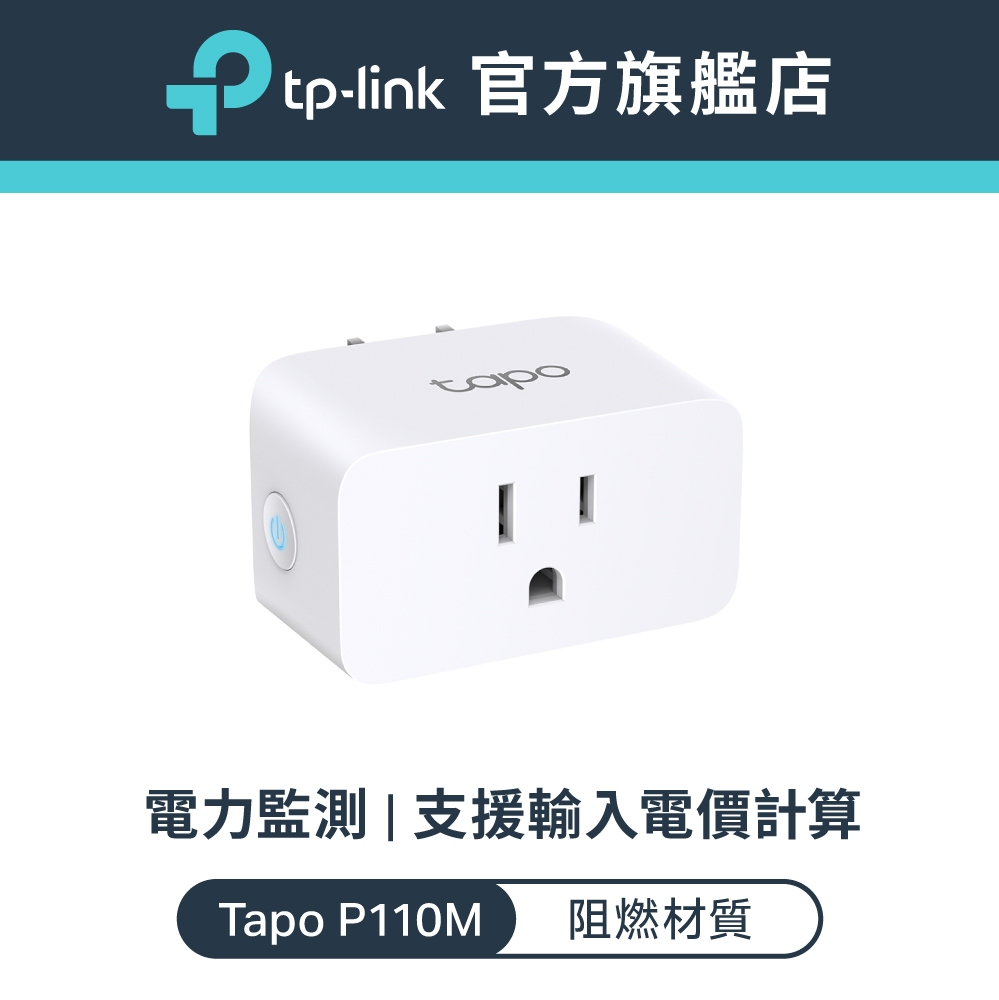
【智慧插座 3】TP-Link Tapo P110M Wi-Fi 迷你無線智慧插座 (支援 Matter / 電力監控)
本文含蝦皮分潤連結,透過連結購買我會獲得少量回饋,不影響你的價格。
本文發佈於 vkinngworld|YouTube @vkinng
