顯示具有 NVIDIA 標籤的文章。 顯示所有文章

2026年11月7日 星期六

CPO矽光子原理:為何矽不會發光,只能外掛InP雷射

CPO矽光子原理:為何矽不會發光,只能外掛InP雷射

CPO矽光子原理:為何矽不會發光,只能外掛InP雷射

重點先講:矽做得出奈米電晶體,卻發不出有效雷射光——因為它是間接帶隙半導體:電子復合時能量多變熱、少變光子。這是材料物理,不是台積電製程極限。所以今天的 Gen-1 CPO(Broadcom/台積電 COUPE 路徑)選擇「燈泡掛外面」:前面板可替換的 CW InP 外部雷射源(ELS)+光纖進 PIC+片上調變器刻 0/1。理想派想把 III–V 發光材料直接貼上矽,但 CTE、熱與老化仍挡量產。

原始貼文在這:FB:矽不會發光與 CPO 外掛雷射

發生了什麼

  • 物理底線:矽=間接帶隙 → 輻射復合效率極低。矽光子仍可在約 220 nm SOI 波導引導/調變近紅外光;偵測器常用 Ge-on-Si;雷射增益介質需 III–V(典型 InP)。
  • Gen-1 CPO 架構:連續波(CW)外部雷射源模組(常為 InP)裝在前面板/可替換 ELS;光纖耦合進 PIC;片上調變器(microring/MZM/EAM)刻資料。雷射遠離高熱交換 ASIC;可熱插拔,不必整顆 CPO 報廢。
  • 台積電 COUPE/CPO 公開敘事:CPO 量產約 2H2026;矽光子占光收發器市場份額 2027 年 >50%(副總 Hsu 引述見 Taipei Times/SEMICON Taiwan 報導)。點名瓶頸:雷射、光纖、連接器、光偵測器、封裝、光耦合、測試。
  • NVIDIA Spectrum-X/Quantum-X CPO 產業報導(2026):外掛 CW InP;一則對 Quantum-X800 類架構描述為多個 SiPh 引擎共用較少高功率 CW 雷射(約 4 引擎:1 雷射)相對可插拔每通道 EML——雷射顆數下降,高功率 CW InP 需求上升。Lumentum 曾談 CW 雷射供需缺口/溢價(財報評論)。
  • 未來:台積電路徑圖(TechOrange/TechNews)提後期 CPO-OI 可在 COUPE 背面整合調變/放大/雷射——無量產日。III–V 鍵合上矽仍是理想,CTE/熱/可靠度挡量產。
一句話對照:主流派=「燈泡掛外面」(ELS+光纖+片上調變);理想派=「把發光材料貼上矽」(III–V 異質整合)。前者已在 Gen-1 CPO 落地;後者研究熱、量產冷。
工程重點 1:間接帶隙不是「製程沒做好」

直接帶隙(InP、GaAs)電子與電洞可對齊動量直接復合發光;矽導帶底與價帶頂不在同一 k 點,復合常需聲子協助,效率極差——電流大多變熱。矽可當優秀波導與調變平台(約 220 nm SOI),卻不當本征雷射增益介質。把「CPO 外掛雷射」講成製程妥協,是把物理誤讀成工程偷懶。

工程重點 2:外掛 ELS=用耦合損換可維修性與熱隔離

CW InP 放前面板可替換模組,代價是光纖耦合損與對準公差;好處是遠離交換 ASIC 熱區,老化/故障可換 ELS、不必報廢整顆 CPO。作者定性:ASIC 表面約 85–100°C、InP 偏好較涼接面時,毫米級共封裝會惡化臨界電流與壽命——熱動機方向說明,非量測 ΔT。粉專概括「燈泡掛外面」,方向正確。

工程重點 3:雷射「顆數」下降,不等於 InP 需求下降

可插拔常是每 lane 一顆 EML;CPO 共享 CW 架構可用少數高功率 CW InP 餵多個 SiPh 引擎。作者示意:1 顆分給 4 引擎 → 顆數約 −75%,分光前每顆約須 4× 光功率(非規格書)。故產業可同時說「顆數變少」與「高功率 CW InP 供需緊/溢價」(Lumentum 等財報評論)。

工程重點 4:異質整合是理想,CTE 與可靠度是帳單

InP 增益層鍵合上矽可縮光路、減耦合件,簡報很愛畫。實務上 III–V/矽 CTE 失配帶來應變與裂紋,加上高溫與老化,量產良率與現場壽命仍是硬牆。台積電路徑圖的後期 CPO-OI(光學中介層整合調變/放大/雷射)目前沒有公開量產日;在那之前 Gen-1「外掛 ELS」仍是可出貨路徑。粉專對照「燈泡掛外面」與「發光材料貼上矽」:FB 原文。

還缺什麼/待核

  • CPO 2H2026 量產、SiPh 2027 市占 >50% 為公開敘事/報導引述,非本文審計的出貨數字。
  • 「4 引擎:1 雷射」為特定架構報導描述,不宜外推成所有 CPO 產品的固定比。
  • CPO-OI 整合雷射路徑圖無量產日;異質鍵合量產時程仍屬研究/產業展望。
  • 作者熱動機與 4× 功率示意為定性/數量級,非實驗室量測或供應商規格書。

延伸影片

矽光子與 CPO矽光子與 CPO:光怎麼走進交換晶片

你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!

你覺得「燈泡掛外面」還能撐幾代 CPO,還是 III–V 異質整合會先破局?留言告訴我。

資料來源:間接帶隙/矽光子基礎物理;台積電 COUPE/CPO 公開敘事與 Taipei Times/SEMICON Taiwan 對 Hsu 副總引述;NVIDIA Spectrum-X/Quantum-X CPO 產業報導;Lumentum 等對 CW 雷射供需之財報評論;TechOrange/TechNews 對台積電 CPO-OI 路徑圖整理;FB 粉專原文。標示「作者估算」「報導稱」「公開敘事」者非官方出貨稽核數字。
本文由 vkinngworld/@vkinng 整理。這題在粉專討論很熱,歡迎來留言:FB 粉專「PLC」
2026年11月6日 星期五

台積電CoWoP架構解析:砍掉ABF載板後,AI封裝省什麼又犧牲什麼

台積電CoWoP架構解析:砍掉ABF載板後,AI封裝省什麼又犧牲什麼

台積電CoWoP架構解析:砍掉ABF載板後,AI封裝省什麼又犧牲什麼

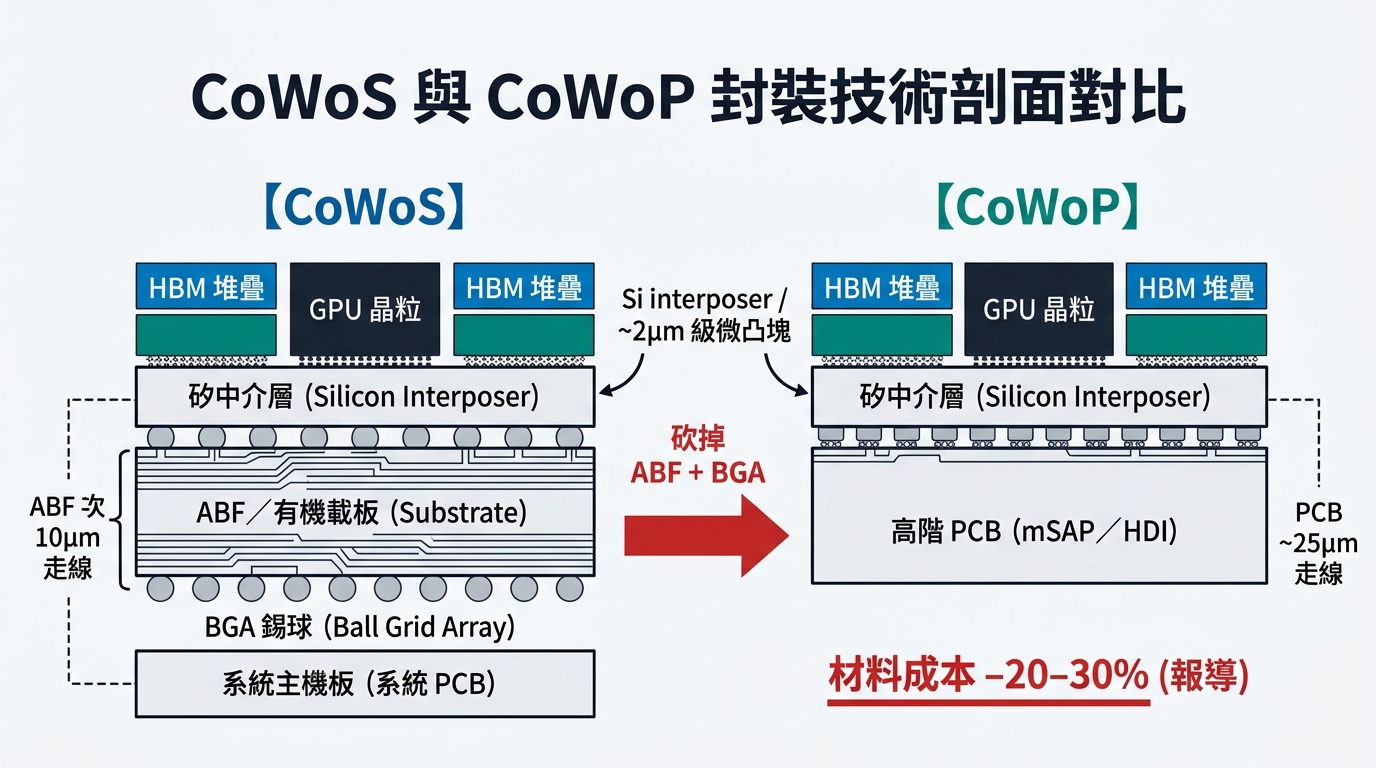
重點先講:CoWoS 最貴、最卡的一層,常常不是矽中介層本身,而是底下那片 ABF/BT 封裝載板加上 BGA。供應鏈近期討論的 CoWoP(Chip-on-Wafer-on-PCB),核心構想很直白:GPU 與 HBM 之間仍靠矽中介層做微米級互連,但整疊「Chip-on-Wafer」改直接落到高階 PCB,砍掉傳統封裝載板與錫球。省材料、縮路徑、簡供應鏈——聽起來很香;線寬變粗、翹曲與良率帳單,則是另一面。

發生了什麼

  • 定義(產業分析用語,非台積電正式產品發表):CoWoP 保留矽中介層服務 GPU↔HBM 細間距;以 mSAP/HDI 等級高階 PCB 取代 ABF/BT 載板+BGA(DigiTimes、工商時報等供應鏈報導)。
  • 報導宣稱效益:砍掉 ABF+BGA 後,封裝材料成本約可降 20–30%;電氣路徑可縮短約 40%(DigiTimes 一則);熱路徑不必再穿過 ABF;PCB 產能與週期相對較有彈性。
  • 工業壓力:OCP APAC 2026,台積電先進封裝負責人何軍指出 CoWoS 5.5 倍光罩已量產、良率約 98–99%,並點名 ABF 載板與記憶體仍是瓶頸——這正是「跳過載板」構想有人聽的背景(第三方整理)。
  • 市場傳:輝達可能以 CoWoS+CoWoP 雙軌應對 Rubin GR150(約 2026 年 10 月供應鏈傳聞);JPM/MS/Ming-Chi 等分析師對中期大量採用偏懷疑。台積電自己較清楚的公開敘事仍是 CoPoS 面板級封裝(約 2026 試產、2028 量產量級),CoWoP 相對仍屬早期概念。
  • 粉專整理/市場傳:矽中介層單價約 US$15k 量級、14 層 ABF 良率壓力、報價上漲約 20%、Rubin 長達約 52 週交期——本文當「市場合成」引用,非財報稽核數字。10 月法說電話會議亦有先進封裝需求「very large gap」的評論轉述。
一句話對照:CoWoS = Chip-on-Wafer-on-Substrate(ABF/有機載板+BGA);CoWoP = Chip-on-Wafer-on-PCB(載板層被高階板取代)。兩者都還有矽中介層,不是「不要中介層」。
工程重點 1:砍掉的是載板層,不是微凸塊

GPU 與 HBM 之間的微凸塊、矽中介層上的細線,仍是 CoWoS 家族的價值核心——間距在數微米量級。CoWoP 沒有宣稱要改這一段,而是動「中介層往下」:原本要再過一層高密度 ABF 載板、再用 BGA 焊到系統板;現在改成中介層(或經有限重佈)直接落到可量產的高階 PCB。供應鏈邏輯是:ABF 產能與週期卡得緊,PCB 廠能補;材料帳上少買一片昂貴載板與一層錫球。

工程重點 2:材料省 20–30%,不代表總成本同比例下降

報導口徑是「封裝材料成本約 −20–30%」。作者示意:若 ABF+BGA 本來就占 CoWoS BOM 材料裡的顯著一截,砍掉它們,落在「材料」這欄看到 20–30% 並不奇怪;但同一批報導也提到 PCB 製程費可能約 2 倍於一般板,再加上翹曲補償、測試與重工。因此「材料 −20–30%」≠「整顆模組總成本 −20–30%」。在沒有公開 BOM 拆解前,只能把區間當供應鏈宣稱,不能當審計數字。

工程重點 3:線寬代價——板側 I/O 變粗約 ≥2.5 倍

ABF 載板可做到次 10µm 級線寬/線距;高階 PCB 的 mSAP 常見約 25/25 µm。作者估算示意:25 ÷ 10 = 2.5,也就是板側路由 pitch 粗約 ≥2.5 倍(示意,非量測)。結果是:中介層上的細腳距,下到板端必須做較粗的重佈或較少的直接 I/O——訊號完整性、電源平面分割、逃逸走線都會重新設計。DigiTimes 提到電氣路徑可縮約 40%,方向合理(少一層載板與 BGA 高度),但那是報導數字,不是本文在實驗室量到的。

工程重點 4:翹曲、CTE 與良率,才是真正的工程帳單

矽中介層 CTE 接近矽;有機 ABF 與 PCB 的 CTE 都高得多。把大面積 CoW 直接貼到 PCB,翹曲與熱循環應力不會 magically 消失,只是「應力落在哪一層、用什麼 underfill/補強」換了位置。良率若掉幾個百分點,重工(尤其已貼好 HBM 的昂貴堆疊)很快吃掉材料省下來的錢。這也是分析師對「Rubin 世代就大量走 CoWoP」偏保守的原因:技術演示與供應鏈備援是一回事,吃掉主力產能是另一回事。粉專原文也從載板瓶頸角度聊過這條線:FB 原文:CoWoP 與載板壓力。

還缺什麼/待核

  • 台積電尚未把 CoWoP 列為與 CoWoS/CoPoS 同級的正式量產平台名稱;本文依 DigiTimes/工商時報等供應鏈報導整理,屬產業分析。
  • 「材料 −20–30%」「路徑 −40%」「PCB 製程費約 2×」皆為報導宣稱,缺公開 BOM 與實測驗證。
  • 輝達 Rubin GR150 雙軌、52 週交期、中介層約 US$15k 等為粉專整理/市場傳,非公司財報或規格書。
  • 與 CoPoS(面板、約 2028)的關係:兩者都在紓解載板/產能壓力,但製程與時程不同,不宜混為同一產品。

延伸影片

你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!

SoIC 先進封裝原理SoIC 立體堆疊:比 CoWoS 更近一步的互連

你覺得 CoWoP 會先當 CoWoS 產能備援,還是真能在 Rubin 世代吃掉主力訂單?留言告訴我。

資料來源:DigiTimes/工商時報等供應鏈報導(CoWoP 定義與成本/路徑宣稱)、OCP APAC 2026 何軍演講第三方整理(5.5× 光罩、良率、ABF/記憶體瓶頸)、分析師評論(JPM/MS/Ming-Chi 等對中期量產態度)、台積電 CoPoS 公開敘事、10 月法說先進封裝需求評論轉述、FB 粉專整理。標示「作者估算」「報導稱」「市場傳」者非官方數字。
本文由 vkinngworld/@vkinng 整理。這題在粉專討論很熱,歡迎來留言:FB 粉專「PLC」

2026年10月19日 星期一

800V 直流固態斷路器原理|沒有過零點,AI 機櫃短路為何要在微秒內切斷


重點先講:我們在 SST 影片裡講過「寧願掉一點效率,也要換來保護能力」。上週 OCP 全球峰會(10/12–15)期間,800V 直流機櫃的焦點從「怎麼把電送進去」轉到「出事時怎麼把電切掉」。下面拆四件事:直流為什麼難斷、微秒和毫秒差多少、固態斷路器的導通損耗帳,以及它還不能完全取代機械開關的原因。廠商資訊來自新聞稿與訪談,電流與損耗數字是我的算術示意,不是實測。

發生了什麼

  • 10/12 Power Integrations × Ideal Power:合作開發 800 VDC 固態斷路器,用 1700V GaN 的 InnoMux-2 直接從 800V 母線取電、供給閘極驅動與感測電路,主開關是 Ideal Power 的雙向 B-TRAN。已有可運作原型,參考設計開發中。
  • 10/12 Infineon XDP8HD40S-1:給 ±400V/800V AI 伺服器的數位熱插拔控制器,內建數位 SOA(安全工作區)控制、可驅動 SiC MOSFET+JFET 疊接開關、PMBus 遙測與故障黑盒子紀錄,樣品排在 2027 年第二季。
  • NVIDIA 800 VDC 白皮書第二版:第一批量產系統以塑殼斷路器(MCCB)為主,清除時間最長可能約 20 ms;SSCB 先鎖定 125A 氣冷與 1250A(可能要液冷)兩種規格。

為什麼直流比較難斷?交流電 60 Hz 每 8.3 毫秒(50 Hz 是 10 毫秒)電流就會自然經過一次零點,機械開關只要在零點附近把觸點拉開,電弧就容易熄滅。直流沒有過零點,電弧可以一直燒下去,機械斷路器得靠滅弧室把電弧電壓撐到比系統電壓還高,才能硬把電流壓下來,所以又慢又傷觸點。

工程重點 1:短線路+高電壓=電流瞬間暴衝

AI 機櫃為了省銅、少損耗,電纜盡量短,線路電感很小。短路電流的上升速度大約是 di/dt ≈ V/L。假設迴路電感 1 µH、電阻 5 mΩ(示意值),800V 短路時電流每微秒爬升約 800 A:5 µs 時約 4 kA,若放任 1 毫秒,理論上會衝到接近 160 kA。Infineon 系統架構師 Bernacchia 的說法一樣直白:客戶要求微秒級反應,因為等到毫秒級,電流會到數十萬安培等級,「然後所有東西都毀了」。實際系統會靠電源端的限流與快速關斷壓低故障電流,這也是 NVIDIA 白皮書要求 SST 與整流器具備快速關斷的原因。

工程重點 2:固態斷路器永遠「在路上」,導通損耗要算

機械斷路器的金屬觸點平常幾乎不吃電,固態斷路器則是半導體一直串在主電路上,損耗是 I²R。以 NVIDIA 鎖定的規格算:125A、800V 約 100 kW,開關導通電阻 2 mΩ 時損耗約 31 W,佔 0.03%,還好;到 1250A(約 1 MW),就算只有 1 mΩ 也是 1.56 kW 的熱,集中在一個小盒子裡,這就是 1250A 版本「可能要液冷」的原因。想把損耗壓到 0.05%(500 W),導通電阻得低到約 0.32 mΩ。麻煩的是,Infineon 指出降低導通電阻(晶胞排更密)和提高短路耐受的 SOA 互相矛盾,所以他們選 SiC JFET;Ideal Power 則主打 B-TRAN 的低導通損耗。另一個細節是控制電路的電要從哪來:PI 的做法是直接從被保護的 800V 母線降壓自供電,省掉外部輔助電源。

工程重點 3:快要快,但不能誤跳

GPU 進入訓練時,電流會在極短時間內衝到額定的好幾倍。保護器如果把這當成短路,整個系統就被自己關掉。Infineon 的數位控制器用突波計時器與濾波:短暫的尖峰放行,過電流持續超過預設時間才跳脫。再加上 EMI 濾波器(電感+電容)在負載突變時會振盪,過電流門檻設不好就會誤跳。

工程重點 4:半導體壞掉是「短路」,所以還需要機械氣隙

固態開關反應快、沒有觸點磨耗,但目前功率元件的典型失效模式是短路導通,元件壞了等於沒隔離。所以涉及人員安全的地方,標準仍要求機械繼電器提供物理氣隙與電氣隔離。規模放大後還有並聯問題:1 MW 機櫃需要數十顆元件並聯,關斷時間只要差幾百奈秒,電流就可能集中到某一顆上把它燒掉。NVIDIA 的近期解法是混搭:MCCB 先上、搭配饋線備援或保持時間撐過 20 ms,接頭用機械互鎖(插好鎖定才送電、拔之前先斷電),長期再轉向 SSCB。我的推論是:2026–2027 年 SSCB 會先出現在機櫃內的電源架,配電層級的 1250A 版本要等認證與成本到位。

還缺什麼/待核

  • PI × Ideal Power 只說原型可運作,尚未公布導通損耗、關斷時間、額定電流等數字。
  • Infineon XDP8HD40S-1 是控制器,不是完整斷路器,樣品 2027 Q2;完整 SSCB 仍由客戶或合作方(如 SolarEdge)設計。
  • SSCB 在 IEC/UL 等安全標準下的認證路徑,以及資料中心是否能放寬機械氣隙要求,仍在討論中。
  • 文中 1 µH/5 mΩ 的短路電流與 2 mΩ、1 mΩ 的損耗是示意換算,實際依線路、接地方式與電源限流而不同。

相關影片

今天想問你:如果你在設計 800V 機櫃,你會先用成熟的機械斷路器加備援,還是直接上固態斷路器、多付一點損耗換微秒級保護?留言告訴我你的理由。

想自己動手量電流、看用電?家裡的電當然不是 800V 直流,但「先量得到,才保護得了」的道理一樣。這兩樣是我覺得入門好用的工具:

【萬用電表 1】美國 FLUKE 101 F101 掌上型數位萬用表

【萬用電表 1】美國 FLUKE 101 F101 掌上型數位萬用表

【智慧插座 3】TP-Link Tapo P110M Wi-Fi 迷你無線智慧插座 (支援 Matter / 電力監控)

【智慧插座 3】TP-Link Tapo P110M Wi-Fi 迷你無線智慧插座 (支援 Matter / 電力監控)

本文含蝦皮分潤連結,透過連結購買我會獲得少量回饋,不影響你的價格。

2026年2月5日 星期四

【深度解析】輝達、台達電、台積電的三角戰略:為何 800V 是台達的 CoWoS 時刻?


最近大家都在討論 NVIDIA 的 800V 機櫃,但身為工程師,我們要看的是背後的「規格主導權」。很多人問:為什麼這波電力架構又是台達電領跑?

🔌 觀念校正:800V 不是拿來直接餵給 GPU 的

先建立一個專業共識:雖然機櫃打著 800V 的名號,但這高壓要是直接灌進晶片,保證你會看到價值百萬台幣、轉瞬即逝的「數位煙火」。😂

邏輯跟你家裡的 PC 一樣:家用插座 110V AC 需要轉成 12V DC 給 CPU;而 AI 機櫃則是將進入機櫃門口的 800VDC,透過內部的 電源供應器(PSU) 進行精密降壓與整流,最後才餵給 GPU 使用。800V 只是這條電力高速公路的「載體電壓」。

🧱 一條龍的霸權:從台電電網到 AI 機櫃

這整套 800V 系統之所以強大,是因為台達電實現了從源頭到末端的完全控制。讓我們一步步拆解這 800V 到底是怎麼來的,你就會發現恐怖之處:

1. 源頭(Grid): 電力公司(台電)提供的高壓交流電進入數據中心。

2. 核心轉換(SST): 透過台達電的 SST(固態變壓器),直接將高壓電轉成 800VDC(直流電)。

3. 定義權在誰手上?

• 因為 SST 是台達做的,SST 的輸出能力直接決定了「電流上限」。

• 既然電流上限我訂的,那後面傳輸 800VDC 的匯流排(Busbar)銅排要多粗? 當然是台達電說了算。

• 再往下走,線拉到了機櫃門口,機櫃的 800VDC Input 接頭要用什麼定義、長什麼樣子? 因為前後端都是自己人,當然也是台達電直接定義!

這就是「一條龍」的威力:從高壓轉 800V 的 SST,到中間的傳輸路徑,再到機櫃端的接頭,全部都是台達自家的產品。自己人溝通規格最快、效率最高,其他人想插手?連門都沒有。

🛡 技術護城河:台達電 vs. 台積電

這種策略其實跟台積電(TSMC)的發展路徑極其相似:

• 台積電的 CoWoS 封裝: 如果台積電只做晶片代工,對手仍有追趕空間。但當它祭出 CoWoS-L 封裝,將先進製程與複雜的封裝技術「捆綁」時,對手就難以競爭。因為客戶買的不只是晶片,是整套效能優化過的系統方案。

• 台達電的系統鎖定: 如果台達只做 SST 或 PSU 這種單一元件,也難以獨大。但當它將 「SST 源頭 + 800V 傳輸定義 + 機櫃接頭 + PSU」 整合成一套標準時,就如同台積電的先進封裝一樣,築起了極高的競爭門檻。

結論: 在 AI 時代,單打獨鬥的零件商已經失去優勢,唯有從源頭就定義規格、掌握系統整合能力的贏家,才能在算力浪潮中站穩腳步。

#NVIDIA #輝達 #台達電 #台積電 #800VDC #CoWoS #SST #固態變壓器 #AI基礎設施 #系統整合 #技術解析

2026年2月4日 星期三

你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!揭秘 NVIDIA 瘋搶的封裝黑科技


最近 AI 浪潮席捲全球,大家一定常聽到 NVIDIA 的晶片產能卡在台積電的「CoWoS」封裝。 但很多人誤以為 CoWoS 只是一種技術,其實你只對了一半! 為了同時滿足高效能、低成本與巨大尺寸的需求,台積電其實將 CoWoS 演化出了三種截然不同的「變體」:CoWoS-S、CoWoS-R 與 CoWoS-L。

這三種技術到底差在哪? 為什麼強如黃仁勳也得乖乖排隊? NVIDIA 最新的怪物晶片 Blackwell 又是用哪一種? 今天的影片,我們就來把艱澀的半導體知識,變成連小學生都能聽懂的科普故事!

【關於頻道】 我們專注於科普、冷知識與常見誤解的破解,用最口語的方式帶你看懂這個世界。 每週四、週日 下午 5:00 準時更新!

#台積電 #TSMC #CoWoS #半導體 #AI #NVIDIA #黃仁勳 #先進封裝 #科技科普 #冷知識 #Blackwell #CoWoSS #CoWoSR #CoWoSL #晶片

2026年1月31日 星期六

【AI 硬體解密】Nvidia Rubin 的 800V 電源,原來是把「電動車充電站」搬進機房了?🤯⚡️


大家都在討論 AI 晶片的算力,但真正的工程師在看的是「電力架構」的革命。

最近業界熱議 Nvidia 下一代 Rubin 平台 將採用 800V 高壓架構,很多人問:為什麼是 800V?技術哪裡來的?


答案可能會讓你嚇一跳:這整套技術,其實是電動車 (EV) 的零件「轉職」過來的! 🚗➡️💻


特別是台灣的 台達電 (Delta) 之所以能成為電源霸主,就是因為他們把兩樣關鍵的電動車技術,完美移植到了 AI 資料中心:

1️⃣ 第一關:SST 固態變壓器 (把「充電站」縮小進貨櫃)

以前機房要降壓,得靠體積巨大的傳統變壓器。

但在 Rubin 的新架構下,採用了 SST (Solid State Transformer) 技術,能直接把電網的 11kV/22kV 中壓電,一步到位轉成 800V 直流電。

• 🧐 技術源頭: 這其實就是戶外 「MW 級超級充電站」 的核心技術!

• 💡 簡單說: 台達電等於是把路邊那個充電樁的變電箱,優化成一個 「SST 電源貨櫃」。不用傳統變壓器,空間省下來、效率拉到滿!

.

2️⃣ 第二關:800V 轉低壓 DC-DC (把「車載轉換器」塞進機櫃)

電到了機櫃是 800V,但 GPU 晶片不能吃這麼高壓,需要降轉。

• 🧐 技術源頭: 這就是電動車肚子裡的 「HV-to-LV DCDC Converter (高壓轉低壓轉換器)」!

• 💡 簡單說: 在車上,它負責把 800V 動力電降下來推動冷氣、車燈;在 AI 機櫃裡,它負責把 800V 降下來推動 H100/Rubin 晶片。這兩者的技術原理、隔離要求、散熱設計,根本是同一個模子印出來的。


🚀 結論:台達電的「一魚兩吃」戰略

為什麼台達電會笑著數錢?因為他們過去幾年在電動車領域練的功(做充電樁、做車內電源),現在稍微修改一下規格,馬上就能無縫接軌賣給 Nvidia 做 AI 伺服器電源。

「AI 機櫃的電源櫃 ≒ 超級充電站」

「AI 機櫃的轉換器 ≒ 電動車內零件」

科技的盡頭果然是通用的。以後看到 AI 伺服器,別忘了向它致敬,因為它的心臟,其實流著電動車的血!😎


#Nvidia #Rubin #AI #電動車 #800V #SST #固態變壓器 #台達電 #Delta #技術解析 #供應鏈

2026年1月25日 星期日

【半導體科普】破解迷思:為什麼最先進的 CoWoS 封裝,竟然拒絕使用 EUV 光刻機?


在 AI 浪潮下,NVIDIA 的 GPU 一卡難求,大家都知道瓶頸卡在台積電的 CoWoS 先進封裝產能。同時,新聞也不斷報導 ASML 的 EUV (極紫外光) 光刻機有多昂貴、多重要。


這導致了一個常見的邏輯誤區:

「既然 CoWoS 是現在最缺、最先進的技術,那它一定也是用最昂貴的 EUV 機器做出來的吧?」

答案可能會讓你大吃一驚:完全不是! 事實上,CoWoS 製程如果不小心用了 EUV,那才是真正的災難。今天我們就來聊聊,為什麼這項頂尖技術,骨子裡依賴的卻是「成熟」甚至被視為「舊世代」的光刻設備。

1. 先搞懂名詞:什麼是「光刻」?什麼是「曝光」?

在深入 CoWoS 之前,我們先釐清兩個常被混用的詞:

光刻 (Photolithography): 這是整個「製程」的統稱。它的原理就像是洗照片。我們在晶圓塗上感光材料,用光去照它,然後顯影、蝕刻,最後把電路圖案「刻」在晶圓上。

曝光 (Exposure): 這是光刻製程中最關鍵的一個動作。也就是「光線打在晶圓上」的那一瞬間。

先進製程(如 3nm)用的是波長極短的 EUV(極紫外光) 進行曝光。

成熟製程或封裝,通常使用波長較長的 DUV(深紫外光) 進行曝光。

簡單來說: 「光刻」是整套工藝,「曝光」是手上的那把雕刻刀。而 CoWoS 選擇了 DUV 這把刀。


2. CoWoS 的任務:它是「蓋橋」,不是「蓋樓」

為什麼 CoWoS 不需要 EUV?這要從它的任務說起。


先進製程 (3nm 晶片): 台積電在做 NVIDIA H100 的 GPU 核心時,是在方寸之間塞進數百億個電晶體。線路寬度只有幾奈米,這時候非用 EUV 這種「奈米級雷射刀」不可,否則刻不出來。


先進封裝 (CoWoS): CoWoS 的工作,是把做好的 GPU 和旁邊的 HBM (記憶體) 連接起來。 它需要在一個矽中介層 (Silicon Interposer) 上,畫出連接兩者的電路(RDL)。這些線路的寬度雖然比傳統電路板細很多,但通常是在 微米 (µm) 等級(例如 0.4µm ~ 10µm)。


關鍵差異就在這裡: 對於 3nm 的晶片來說,EUV 是必需品。 但對於微米級的 CoWoS 線路來說,EUV 的精度太高了,簡直是**「殺雞用牛刀」**。


3. 為什麼 CoWoS 偏愛 DUV?(三大理由)

台積電選擇使用 DUV(甚至更舊的 i-line 光刻機)來進行 CoWoS 的曝光製程,主要有三個考量:


A. 成本與效率 (Cost & Efficiency)

一台 EUV 造價超過 1.5 億美元,而且曝光速度相對慢(因為光線在真空中衰減很快)。 CoWoS 的線路比較「粗」,用成熟的 DUV 設備不僅跑得快,成本更是只有 EUV 的一小部分。如果硬用 EUV 做封裝,你的顯卡價格可能要再翻一倍。


B. 景深與對焦 (Depth of Focus)

這是一個物理學問題。EUV 的光學系統非常精密,對焦的深度(景深)很淺。這意味著被曝光的表面必須「超級平整」。 但在做封裝時,晶片堆疊後的表面難免會有一點點高低不平。DUV 的波長較長,對這種「不平整」的容忍度較高,更容易成功把電路圖案曝光在基板上。


C. 尺寸限制 (Reticle Size Limit) —— 最致命的原因

這是目前 AI 晶片最大的挑戰。 EUV 設備原本是為了做小巧精密的晶片設計的,它的單次曝光區域 (Reticle Field) 比較小(約 26mm x 33mm)。 但現在的 AI 晶片(如 NVIDIA Blackwell B200)加上封裝後的尺寸超級巨大,早就超過了 EUV 單次曝光的範圍。


相比之下,DUV 技術在處理**「拼接 (Stitching)」**(把多次曝光的圖案接在一起)方面非常成熟。台積電可以用 DUV 輕鬆做出比單一光罩大 3 倍、甚至 4 倍的超大面積中介層,來承載那些巨無霸 AI 晶片。


4. 結論:新舊技術的完美協奏

所以,當我們在談論 CoWoS 產能擴充時,台積電買的並不是 ASML 最貴的 EUV,而是大量的 DUV 曝光設備以及封裝用的貼合機。


這給了我們一個重要的啟示:半導體產業不只是追求「越細越好」,而是追求「最適化」。


大腦 (GPU): 需要 EUV 的極致精度。


身體 (CoWoS): 需要 DUV 的大面積與高效率連接。


下次看到 CoWoS 的新聞,別再以為它跟光刻技術無關,它可是把「阿公級」的光刻機發揮到極致的藝術品呢!

2026年1月24日 星期六

【半導體科普】CoWoS 是什麼?為何 NVIDIA、AMD 都在搶?一次看懂台積電的先進封裝秘密


前言:AI 時代的真正瓶頸不是晶片,而是「封裝」

在生成式 AI 爆發的現在,大家都在討論 GPU 的算力有多強,NVIDIA 的股價又漲了多少。但你有沒有發現,新聞常常提到「產能不足」?其實,卡住出貨的瓶頸往往不是核心晶片本身,而是將這些晶片組裝在一起的技術——先進封裝(Advanced Packaging)。

而在這場封裝戰爭中,台積電的 CoWoS (Chip-on-Wafer-on-Substrate) 技術,就是那個讓 NVIDIA、AMD 甚至 Google 都排隊搶著要的「聖杯」。今天,我們就以自動化工程師的視角,深入淺出地拆解 CoWoS 到底是什麼?以及它旗下的 S、R、L 三種製程究竟有何不同。


一、 CoWoS 到底是什麼?五個字母的秘密

很多專有名詞看名字就能知道結構。CoWoS 也不例外,它的全名是 Chip-on-Wafer-on-Substrate。我們可以把它想像成一個「三層三明治」結構:

  1. 頂層 (Chip): 這是餡料。包含負責運算的邏輯晶片(如 GPU/CPU)以及負責存取資料的高頻寬記憶體(HBM)。

  2. 中層 (Wafer / Interposer): 這是夾層麵包,也是 CoWoS 的核心。我們稱為「中介層」。它負責提供超高密度的線路,讓頂層的 GPU 和 HBM 能夠像鄰居一樣快速溝通。

  3. 底層 (Substrate): 這是底層盤子。通常是 ABF載板,負責將封裝好的晶片連接到外部的電路板(PCB)上。

為什麼需要 CoWoS? 因為「摩爾定律」變慢了。要把晶片做得更小越來越難,成本也越來越高。於是工程師想出了一個辦法:「既然做不小,那我們就把它們『疊』起來,並且『拼』在一起。」 CoWoS 讓處理器和記憶體靠得非常近,大幅解決了傳輸速度(頻寬)的問題,這正是 AI 模型訓練最需要的。


二、 CoWoS 的三種型態:S、R、L 大解密

台積電的 CoWoS 並非只有一種,根據**「中介層(中間那層麵包)」的材質不同**,分為三種主要製程。這也是近期 NVIDIA 晶片世代交替的關鍵所在。


1. CoWoS-S (Silicon Interposer / 矽中介層)

  • 特點: 這是最經典、技術最成熟的版本。中間層使用一片完整的「矽晶圓」來製作。

  • 優勢: 矽的蝕刻技術非常成熟,線路可以做得極度細密,傳輸效能最好,散熱導熱性也佳。

  • 限制: 貴!而且受限於光罩尺寸(Reticle Limit)。簡單說,因為是用矽晶圓做的,它沒辦法做得太大,大概只能塞進一顆 GPU 加上 6 顆 HBM。

  • 代表產品: NVIDIA H100、AMD MI300。

2. CoWoS-R (RDL Interposer / 重佈線層)

  • 特點: 拿掉昂貴的矽中介層,改用有機材料的 RDL(重佈線層)來連接。

  • 優勢: 成本較低,且因為是有機材料,比較有彈性,不容易因為熱脹冷縮而破裂(可靠度高)。

  • 定位: 適合對成本敏感,但仍需要先進封裝的網通或邊緣運算產品。

3. CoWoS-L (Local Silicon Interconnect / 局部矽互連)

  • 特點: 它是 S 和 R 的混血兒,也是未來的主流。主體是有機載板(便宜、可做大),但在晶片與晶片需要高速溝通的「關鍵路口」,埋入小塊的矽橋(LSI)。

  • 優勢: 結合了有機載板「可做超大尺寸」的優點,與矽橋「高密度傳輸」的特性。這突破了 CoWoS-S 的光罩尺寸限制,可以把封裝面積做得比手掌還大!

  • 代表產品: NVIDIA Blackwell B200、GB200。


三、 從 H100 到 B200:為何 NVIDIA 轉向 CoWoS-L?

這是一個非常精彩的技術轉折。

在 H100 時代,NVIDIA 追求極致的穩定與成熟,選擇了 CoWoS-S。這也是為什麼 H100 的效能這麼強,但產能卻一直受限於台積電矽中介層產能的原因之一。

到了 Blackwell (B200) 時代,單一顆晶片已經不夠快了。NVIDIA 決定把兩顆大晶片「拼」在一起,變成一顆超級晶片。 這時候,傳統的 CoWoS-S 就遇到瓶頸了——它塞不下這麼大的面積!

於是,NVIDIA 轉向擁抱 CoWoS-L。透過 CoWoS-L 技術,台積電成功將兩顆運算晶片和 8 顆 HBM3e 記憶體封裝在同一個基板上,實現了 10 TB/s 的驚人傳輸速度。雖然 CoWoS-L 的製程複雜度更高、良率挑戰更大,但這是通往下一代 AI 算力的唯一道路。


結語:封裝工程師的黃金時代

看完這篇,你應該對 CoWoS 有了更深一層的認識。未來的晶片戰爭,不再只是比誰的奈米製程更先進(那是前段製程的事),更要比誰能把這些晶片封裝得更巧妙、更緊密(這是後段封裝的事)。

下一代,我們即將迎來 3nm 製程 與 HBM4 的結合,屆時 CoWoS-L 將會進化得更巨大、更複雜。作為一名自動化工程師,看著這些物理極限被一步步突破,實在是令人熱血沸騰!