2026年10月26日 星期一

台積電 SoIC-X vs SoIC-P 比較:混合鍵合 3D IC 原理,從 9µm 縮到 4.5µm 間距為何關鍵


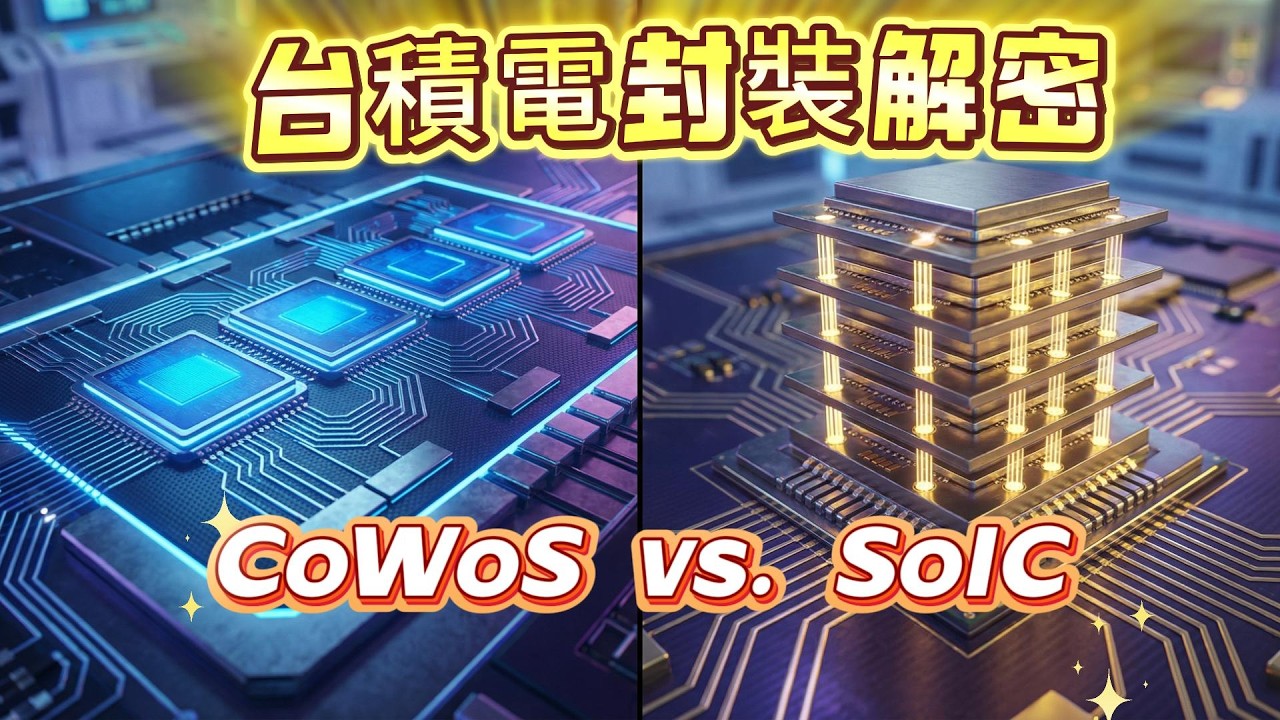
重點先講:我 2 月那支 「TSMC 晶片堆疊大戰」昨晚突然又多了上百次觀看,剛好台積電今年技術論壇把 SoIC 路線圖更新了,這篇把重點補上:SoIC-X 走無凸塊混合鍵合,拚密度和能效;SoIC-P 走微凸塊,拚成本。兩條路怎麼選,關鍵就在「接點間距」。
TSMC晶片堆疊大戰:一次搞懂 SoIC-X、SoIC-P 與 3D IC 封裝的未來

發生了什麼

  • 路線圖更新:台積電表示,9µm 間距的 N7 對 N7 SoIC 2023 年量產,6µm 版本 2025 年量產;N2 對 N2(6µm)預計 2028 年、A14 對 A14(4.5µm)2029 年量產。
  • A14 SoIC:官方新聞稿說,A14 對 A14 的晶粒間 I/O 密度比 N2 對 N2 高 1.8 倍。
  • 產能:供應鏈報導 2026 年 SoIC 月產能約 1 萬到 1.5 萬片,主力在竹南 AP6;法人估每 1 萬片產能投資約 68 到 70 億美元,遠高於 CoWoS。
  • 但也有轉向:DIGITIMES 1 月報導,嘉義 AP7 原本規劃給 SoIC 的 P2、P3 廠改做 CoWoS,因為眼前 CoWoS 缺口更大。

一句話分辨:SoIC-X 是「兩片晶片直接銅貼銅」,中間沒有焊錫球;SoIC-P 是「中間還有一排小焊錫凸塊」。前者像把兩層樓蓋成同一棟,後者像兩棟樓之間搭很多小天橋。

工程重點 1:SoIC-X 和 SoIC-P 到底差在哪

SoIC-X 是無凸塊(bumpless)堆疊:晶片表面做出平整的銅墊和介電層,對準後直接鍵合,銅和銅經過退火擴散接在一起,訊號再經過很細的 TSV 往下走。可以做晶片對晶圓,也有晶圓對晶圓版本(適合兩邊晶片一樣大、良率高的製程)。SoIC-P 則保留微凸塊,2023 年台積電介紹時是 18 到 25µm 間距,鎖定手機、IoT、客戶端這類成本敏感的產品;後續路線圖從 25µm 面對背,走向 16µm 面對面。簡單說:X 拚性能、P 拚價格。

工程重點 2:為什麼間距縮一點就差很多

接點是排成格子的,所以每平方毫米的接點數大約跟間距平方成反比。用最理想的方格去算(示意,不是實際可用 I/O 數):25µm 約 1,600 個/mm²、16µm 約 3,900、9µm 約 12,300、6µm 約 27,800、4.5µm 約 49,400。從微凸塊 25µm 到混合鍵合 6µm,理論密度差約 17 倍。接點多,就能用「很多條慢而短的線」取代「少數幾條快而長的線」,每傳 1 bit 的能量也跟著下降。AMD 在 MI300 的封裝論文就寫,混合鍵合比微凸塊互連密度高 15 倍以上、互連能效高 3 倍以上。Broadcom 也舉過實際數字:面對背約 1,500 訊號/mm²,面對面約 14,000 訊號/mm²。

工程重點 3:良率、散熱和 KGD,才是真正的門檻

混合鍵合沒有焊錫可以「吃掉」誤差,所以表面要極平、極乾淨,一顆微粒就可能造成一片空洞;對準精度也要跟著間距一起縮。第二是良率相乘:兩顆晶粒疊在一起,只要其中一顆壞,整組就報廢,所以晶片對晶圓的做法會先挑出測試合格的晶粒(KGD)再疊。但細間距接點本身很難用探針測,測試策略要事先設計。第三是散熱:上層晶片的熱要穿過下層才能散掉,邏輯疊邏輯時熱點會互相加熱,這也是 AMD 早期 3D V-Cache 要把快取放在 CCD 上方並限制頻率的原因之一。這些都會反映在成本上,所以法人估 SoIC 每萬片的資本支出遠高於 CoWoS。

工程重點 4:SoIC 加 CoWoS/InFO,才是完整的 3D IC

SoIC 本身只解決「垂直疊」。疊好的晶片在外面看起來就像一顆普通 SoC,再放進 CoWoS(2.5D 中介層,旁邊擺 HBM)或 InFO(手機常用的扇出封裝),就成了 3D IC。AMD MI300 就是例子:運算晶粒用 SoIC 疊在 I/O 晶粒上,再放到 CoWoS 中介層旁接 HBM,AMD 自己叫它 3.5D。往後看,供應鏈報導 NVIDIA 2028 年的 Feynman 世代會大幅提高 SoIC 用量,TrendForce 引述報導說 Apple M5 Pro/Max 也開始採用台積電 SoIC 相關封裝。至於 HBM 本身的堆疊,我們 10/21 已經寫過,這裡不重複。

還缺什麼/待核

  • 每平方毫米接點數是用理想方格算的示意值,實際可用的訊號數會因電源、接地和冗餘接點而少很多。
  • 2024 年論壇的舊路線圖曾寫 2027 年 3µm,今年官方說法是 2029 年 4.5µm(A14 對 A14),兩者口徑不同,本文以 2026 年官方資料為準。
  • 2026 年產能、每萬片投資金額、NVIDIA 與 Apple 採用情形,都是供應鏈或媒體報導,台積電沒有正式公布。

影片連結

主影片:TSMC晶片堆疊大戰:一次搞懂 SoIC-X、SoIC-P 與 3D IC 封裝的未來

▶ 看完整影片(@vkinng)

延伸觀看:你以為 TSMC 的 CoWoS 只有一種嗎?其實是三種!(CoWoS-S/R/L)、銅線撐不住了!硬核拆解「矽光子」與 CPO 終極封裝(台積電 COUPE 光引擎也是用 SoIC 疊的)。

你覺得下一代 AI 晶片會全面走 SoIC-X 混合鍵合,還是成本壓力會讓 SoIC-P 和 CoWoS 撐更久?留言聊聊。

2026年10月25日 星期日

AI 寫程式除錯迴圈解析:你以為在命令 AI,其實是你在幫它複製貼上、回報 bug


重點先講:我在 Facebook 發了一支短 Reel,講一個很多人每天都在經歷、卻很少說破的事:你以為是你在命令 AI,其實是 AI 在給你內容,你負責複製、貼上、遇到 bug、回報,再修正。一輪又一輪,到底誰才是操作員?這篇用工程和自動化的角度把它拆開,最後講怎麼把角色翻回來。

▶ 看完整 Reel(Facebook)

Reel 在講什麼

  • 第 1 步:你下指令,AI 一口氣吐出一大段程式碼或設定。
  • 第 2 步:你複製、貼到編輯器或 PLC 專案,存檔、編譯、執行。
  • 第 3 步:出現錯誤訊息,你再把錯誤貼回去給 AI。
  • 第 4 步:AI 道歉、給新版本,你再複製、貼上……回到第 2 步。

用控制迴路來看:設定值是你想要的功能,控制器是 AI,受控體是你的程式和設備,而「量測、回授」這一段全靠你手動抄錯誤訊息。在工廠裡,沒有人會讓操作員每個掃描週期都看一次錶、再把數字打回 PLC;但寫程式時,我們常常就這樣做。

工程重點 1:AI 看不到執行結果,所以一定要驗

聊天視窗裡的 AI 沒有你的執行環境:它不知道你裝了哪個版本的函式庫、PLC 韌體是哪一版、I/O 實際怎麼配。它只能「猜一個看起來合理的答案」。最典型的是幻覺套件:USENIX Security 2025 的論文用 16 個模型產生 57.6 萬段程式碼,推薦的套件裡約 19.7% 根本不存在;商用模型平均約 5.2%,開源模型約 21.7%。這些名字還可能被有心人搶註,變成供應鏈攻擊。再加上對話一長,前面講過的限制條件容易被忽略,你就會看到同一個 bug 修好又回來。

工程重點 2:「感覺變快」不等於真的變快

METR 在 2025 年做過一個隨機對照實驗:16 位資深開源開發者在自己熟悉的專案裡做 246 個任務,允許用 AI 的那組反而多花了 19% 時間,但他們事後仍自認快了 20%。螢幕錄影顯示,省下的打字時間被「看 AI 輸出、寫提示、等它生成」吃掉了。這正是 Reel 裡那個迴圈的成本。公平地說,METR 在 2026 年 2 月已經表示這份結果過時了,新工具可能真的變快,只是新數據證據力還很弱。重點不是 AI 好或壞,而是人在迴圈裡手動搬運的時間,沒有被算進去。

工程重點 3:把角色翻回來,先給規格和驗收條件

做過 PLC 專案的人都知道,開工前要先有 I/O 表、動作時序、連鎖條件,交機前要跑 FAT/SAT。對 AI 也一樣:不要只說「幫我寫一段程式」,而是先給規格、限制、輸入輸出範例和測試案例,例如「這個函式輸入 X 要回傳 Y、遇到斷線要在 3 秒內報警」。有了驗收條件,你就從「幫 AI 抄錯誤的人」變成「定義什麼叫完成的人」,AI 每次給的東西也能直接對著測試判斷對錯。

工程重點 4:把回授自動化,人只管設定值和最後放行

下一步是把「複製、貼上、執行、回報」這段交給機器:讓 AI 代理能直接在專案裡執行測試、讀錯誤訊息、自己修,再用 CI、靜態檢查、型別檢查擋住明顯錯誤。就像把手動抄表改成感測器直接接進 PLC,回授迴路閉合在自動化裡,人退到監督層:訂規格、審關鍵變更、決定上線。要注意,碰到實體設備的程式,還是要有模擬或安全連鎖,不能讓 AI 直接改現場。

還缺什麼/待核

  • Reel 內容依作者描述撰寫;實際畫面與細節請以 Facebook 原片為準。
  • 19.7% 幻覺套件率是論文測試當時的模型(含 GPT-4、CodeLlama 等),新模型的比例可能不同。
  • METR 的 19% 變慢是 2025 年初的工具與特定情境;METR 自己已說明結果過時。
  • 文中控制迴路與 PLC 的比喻是作者觀點,不是研究結論。

看完整 Reel

這個「人變成 AI 的複製貼上機」的畫面,Reel 裡演得更直接:

▶ 到 Facebook 看 Reel

你用 AI 寫程式或寫 PLC 時,最常卡在哪一步?是複製貼上、找 bug,還是 AI 一直修不好同一個錯?留言聊聊,順便到 Reel 那邊分享你的經驗。

2026年10月24日 星期六

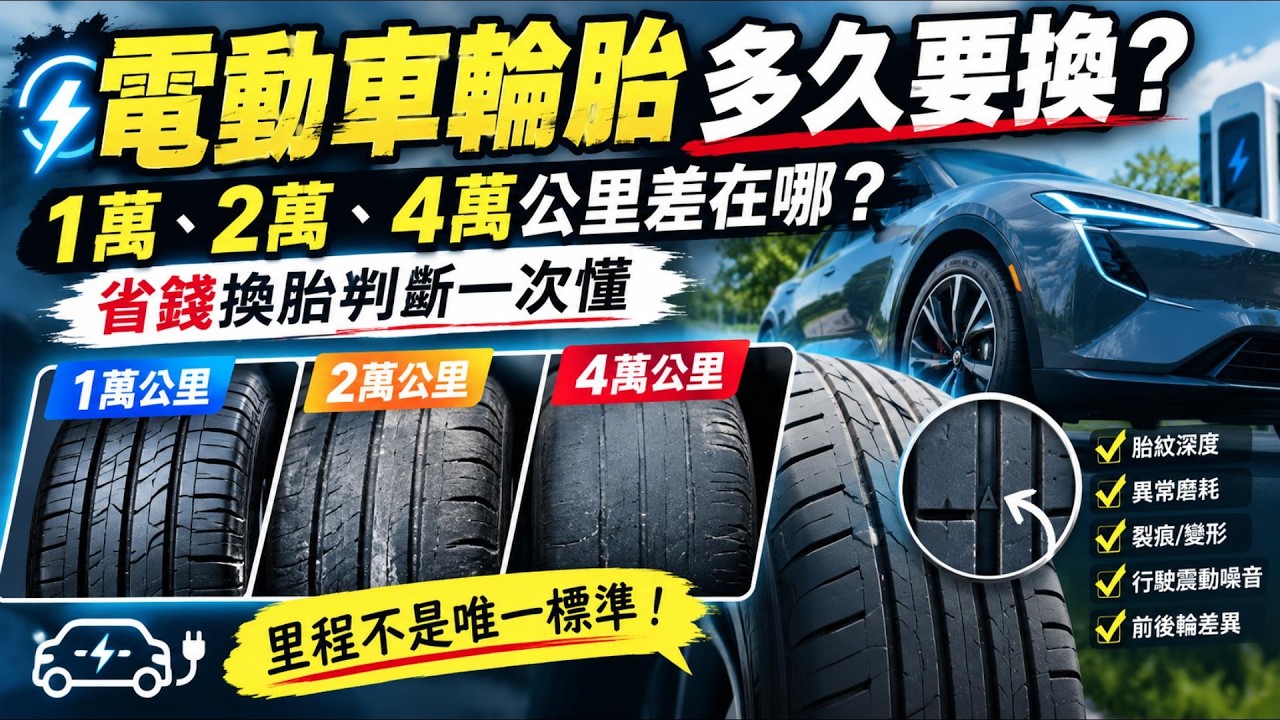
電動車輪胎磨耗原理|重量、瞬間扭力、動能回收怎麼磨掉胎紋?剩 2mm 濕地煞車多 5 公尺


重點先講:新片〈電動車輪胎多久要換?1萬、2萬、4萬公里差在哪?換胎判斷一次懂〉用 1 萬、2 萬、4 萬公里三個里程點講換胎時機。這篇不重複檢查清單,改講背後的物理:胎紋到底是怎麼被磨掉的、為什麼電動車的重量、瞬間扭力和動能回收會讓它磨得更快,以及磨淺之後雨天煞車會差多少。文中的換算是我用簡化模型做的示意,不是實測數據。

發生了什麼

  • 新片:@vkinng 剛上架換胎判斷影片,用三個里程點拆解電動車輪胎的壽命。
  • 法規底線:台灣《道路交通安全規則》第 39 條要求胎面不得磨到 CNS 1431 的磨耗指示點,也就是溝底起算 1.6 mm;歐洲同樣是 1.6 mm。
  • 實務建議:ADAC 建議夏季胎至少 3 mm、冬季胎至少 4 mm;Tesla 維修手冊也寫任一點 ≤ 3 mm(4/32 in)就建議換胎。

磨耗的簡化模型:橡膠磨耗大致跟接地面裡的「摩擦功」成正比,也就是 力 × 滑移距離。小滑移時,縱向力 Fx ≈ Cs × 滑移率 κ,而縱向剛性 Cs 大致跟輪胎負重成正比。整理後,每公里的滑移摩擦功約與 m × a² 成正比:車重是線性,加速度是平方。(簡化刷子模型,僅供量級判斷)

工程重點 1:重量放大一倍,猛踩讓它變四倍

輪胎接地面不是整片黏在地上。胎面花紋塊進入接地面時先被壓住、跟著路面走,越往後剪切變形越大,到了後段抓不住就開始局部滑移,磨耗主要就發生在這裡。用上面的模型:一台 2,000 kg 的電動車對上 1,600 kg 的油車(重量為示意),同樣加速度下磨耗能量約多 25%。但電動車真正的問題是扭力隨踩隨到,駕駛很容易用 0.3 g 起步;跟 0.15 g 溫和起步相比,每次起步的磨耗能量約是 4 倍。所以同一台車,開法造成的差距常比車重還大。

工程重點 2:動能回收把煞車力集中在驅動軸

油車煞車時,摩擦煞車把力分到四個輪子,前輪約佔六到七成。電動車的動能回收則只靠驅動軸的馬達,每次鬆油門,驅動輪就要多吃一次縱向力。後驅車的後輪因此要同時負責加速和大部分的減速,驅動軸的胎紋常比另一軸磨得快。這也是為什麼 Tesla 建議每 10,000 km,或前後胎紋差達 1.5 mm 時就換位。回收強度設高一點本身不是壞事,突然收油造成的大減速度才是磨耗來源。

工程重點 3:耐磨膠料的代價

要讓胎面耐磨,廠商可以用更硬、遲滯更低的膠料,或加深花紋、加強胎肩剛性。問題是濕地抓地需要遲滯:橡膠在路面微小凹凸上變形、吸收能量,才咬得住濕滑路面。膠料太硬,耐磨和滾阻變好,濕地煞車就可能變差。所以 EV 專用胎通常是在耐磨、滾阻、濕地抓地三者之間取捨,而不是三項都贏。買胎時要同時看歐盟標籤的濕地抓地等級,不能只看耐磨保證里程。

工程重點 4:胎紋變淺,雨天煞車距離變長

胎紋溝槽的工作是把水排出接地面。粗算一下(我的算術):時速 100 公里、胎寬 205 mm、路面積水 1 mm,每顆胎每秒要處理約 5.7 公升的水。新胎約 7~9 mm 深,磨到 3 mm 時溝槽容積只剩大約三分之一(以直壁溝槽估算)。ADAC 實測,磨到 4 mm 的輪胎在時速 63 km 就開始水漂,新胎要到 87 km;磨到 2 mm 時,時速 80 公里濕地煞停距離從 31.9 m 增加到 37.3 m,約多 17%。最後那 1~2 mm 損失的安全餘裕,比前面磨掉的好幾 mm 還多。

還缺什麼/待核

  • 「電動車比油車吃胎快 20~30%」是業界常見說法,沒有統一的第三方數據,實際依車款、胎款和開法差很多(待核)。
  • m × a² 是簡化刷子模型的結果,只適用小滑移區,真實磨耗還跟路面粗糙度、胎溫、定位有關。
  • 2,000 kg 與 1,600 kg、0.3 g 與 0.15 g、5.7 L/s 都是作者示意算術。
  • ADAC 的距離數據來自特定胎款與測試條件,不同輪胎的結果會不同。

相關影片

你的電動車開多少公里換第一套胎?是哪一軸先磨完?留言告訴我,我想整理一份車主實際數據。

資料來源:ADAC:abgefahrene Reifen 磨耗輪胎測試;ADAC:胎紋深度建議;ADAC:水漂現象;Tesla Model Y 維修手冊:輪胎換位;道路交通安全規則第 39 條;NHTSA:輪胎安全。車重、加速度、排水量等換算皆為作者假設與示意算術。
發佈於 vkinngworld|影片頻道:@vkinng